Documentación de K0lmenIA
104 agentes de QA para Claude Code: documentación del proyecto, diseño de pruebas, ejecución en vivo, automatización con k0lmena e integración con Xray, QMetry, AIO Tests, Zephyr, k0lmenaTMT y Azure DevOps.
Qué es K0lmenIA
Un equipo de agentes especializados en QA para Claude Code, pensado para profesionales de testing manual: no hace falta programar, se trabaja conversando dentro de VS Code.
Ponés un insumo (una historia, una observación de bug, un contrato de API, o directamente una key de Jira o un link de Figma), pedís lo que necesitás en lenguaje natural y el agente que corresponde genera el resultado: análisis, planes, casos en Excel o Gherkin, datos, bugs, reportes HTML, automatización y carga en la herramienta de gestión.
1 · Diseño
Analizar historias, planificar, escribir y revisar casos manuales, BDD y de API (con su tiempo estimado), generar datos y charters, y redactar bugs.
output/2 · Automatización
Los agentes mapper escriben la automatización una sola vez; después corre con npm, sin tokens.
herramientas/k0lmena/3 · Gestión
Casos, ciclos y resultados con evidencias en Xray, QMetry, AIO Tests, Zephyr o k0lmenaTMT (casos también en Azure DevOps), y el informe de cierre.
output/Principios
| Principio | En la práctica |
|---|---|
| No inventar | Si falta un paso, un dato, una regla o un umbral, el agente lo marca y lo pregunta. Mejor un artefacto con huecos señalados que uno completo pero inventado. |
| Respetar los formatos | Los campos, su orden y sus valores los definen las plantillas y los scripts, no el agente. |
| Trazabilidad | Todo referencia la historia (HU-XXX); cada escenario automatizado lleva el ID del caso (@CP-001) y la key de la herramienta de gestión. |
| Cobertura pensada | Positivos, negativos, bordes y validaciones de campos, no solo el camino feliz. |
| Investigar antes de suponer | Antes de trabajar una historia se revisan la documentación del proyecto (repositorio, PRs, mapa de la web), sus comentarios, subtareas, épica, issues vinculados, Confluence y Figma. Lo que no aparece queda marcado como Falta información (FI-01). |
| Ahorro de tokens | Lo que se repite se automatiza una vez y después corre sin agentes. |
| Seguridad | Los secretos viven en el .env de la raíz, que nunca se versiona; los agentes nunca piden tokens por el chat. |
| Dos idiomas | Cada informe sale en español y en inglés, con una banderita para elegir cuál mandar. |
| Donde trabajes | Clonando este repo o instalándolo como plugin de Claude Code en la carpeta de cualquier proyecto: las actualizaciones llegan sin tocar tu trabajo. |
Arquitectura
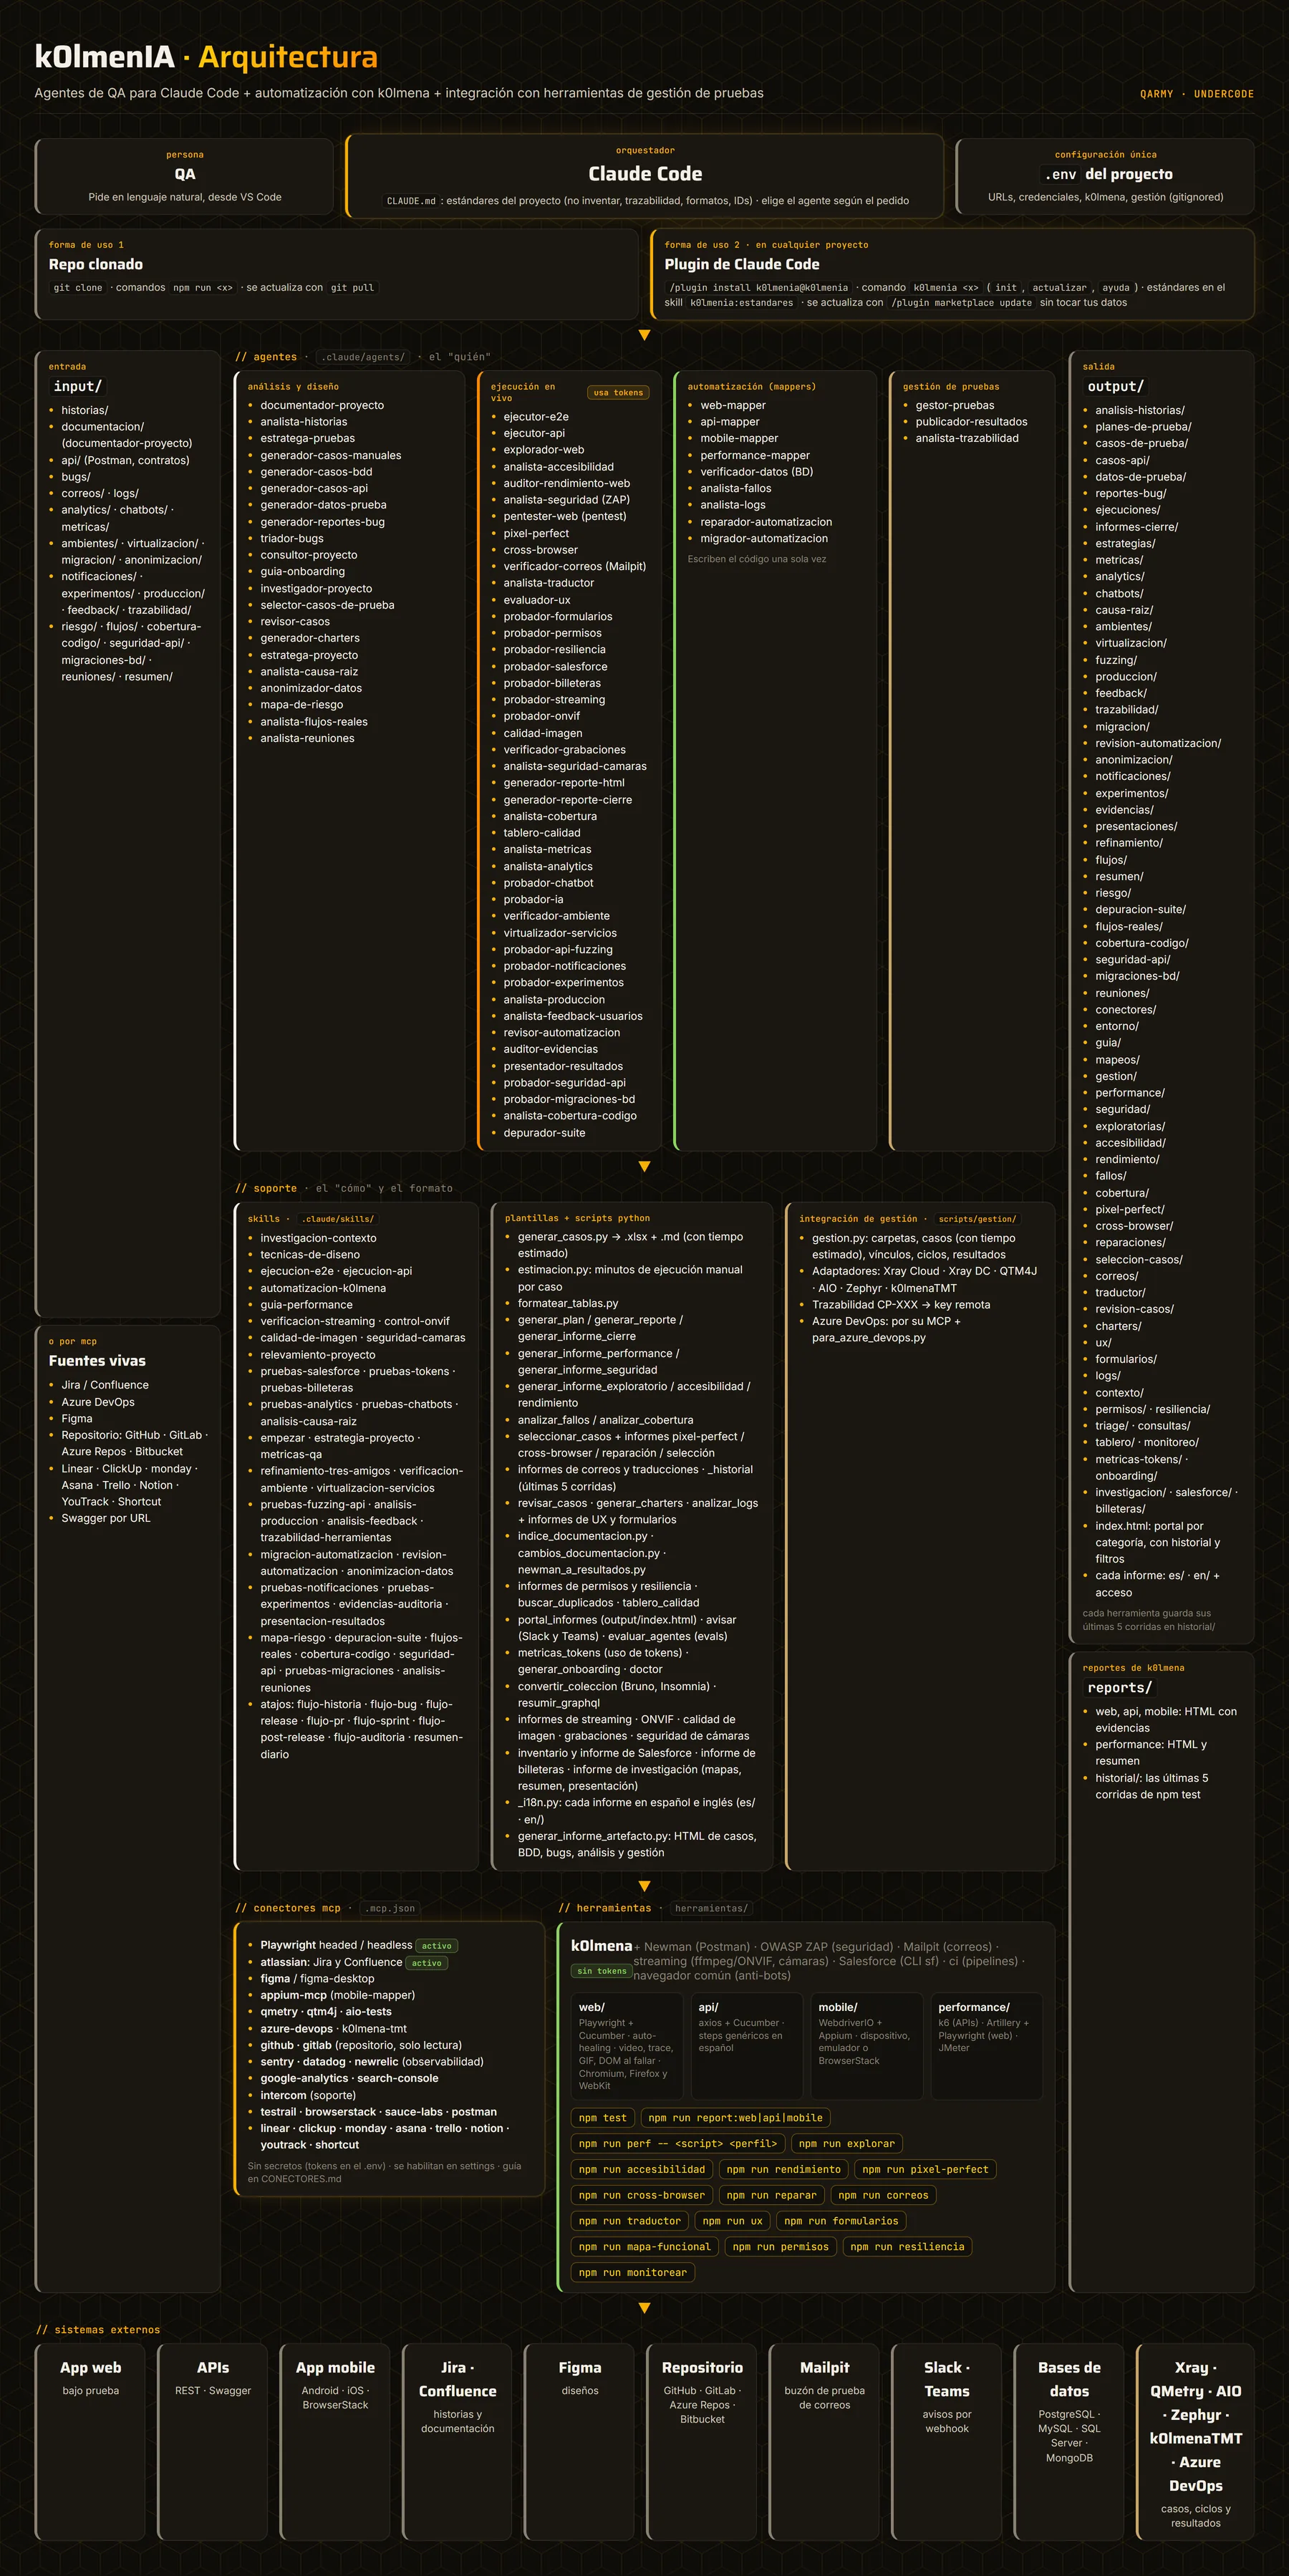
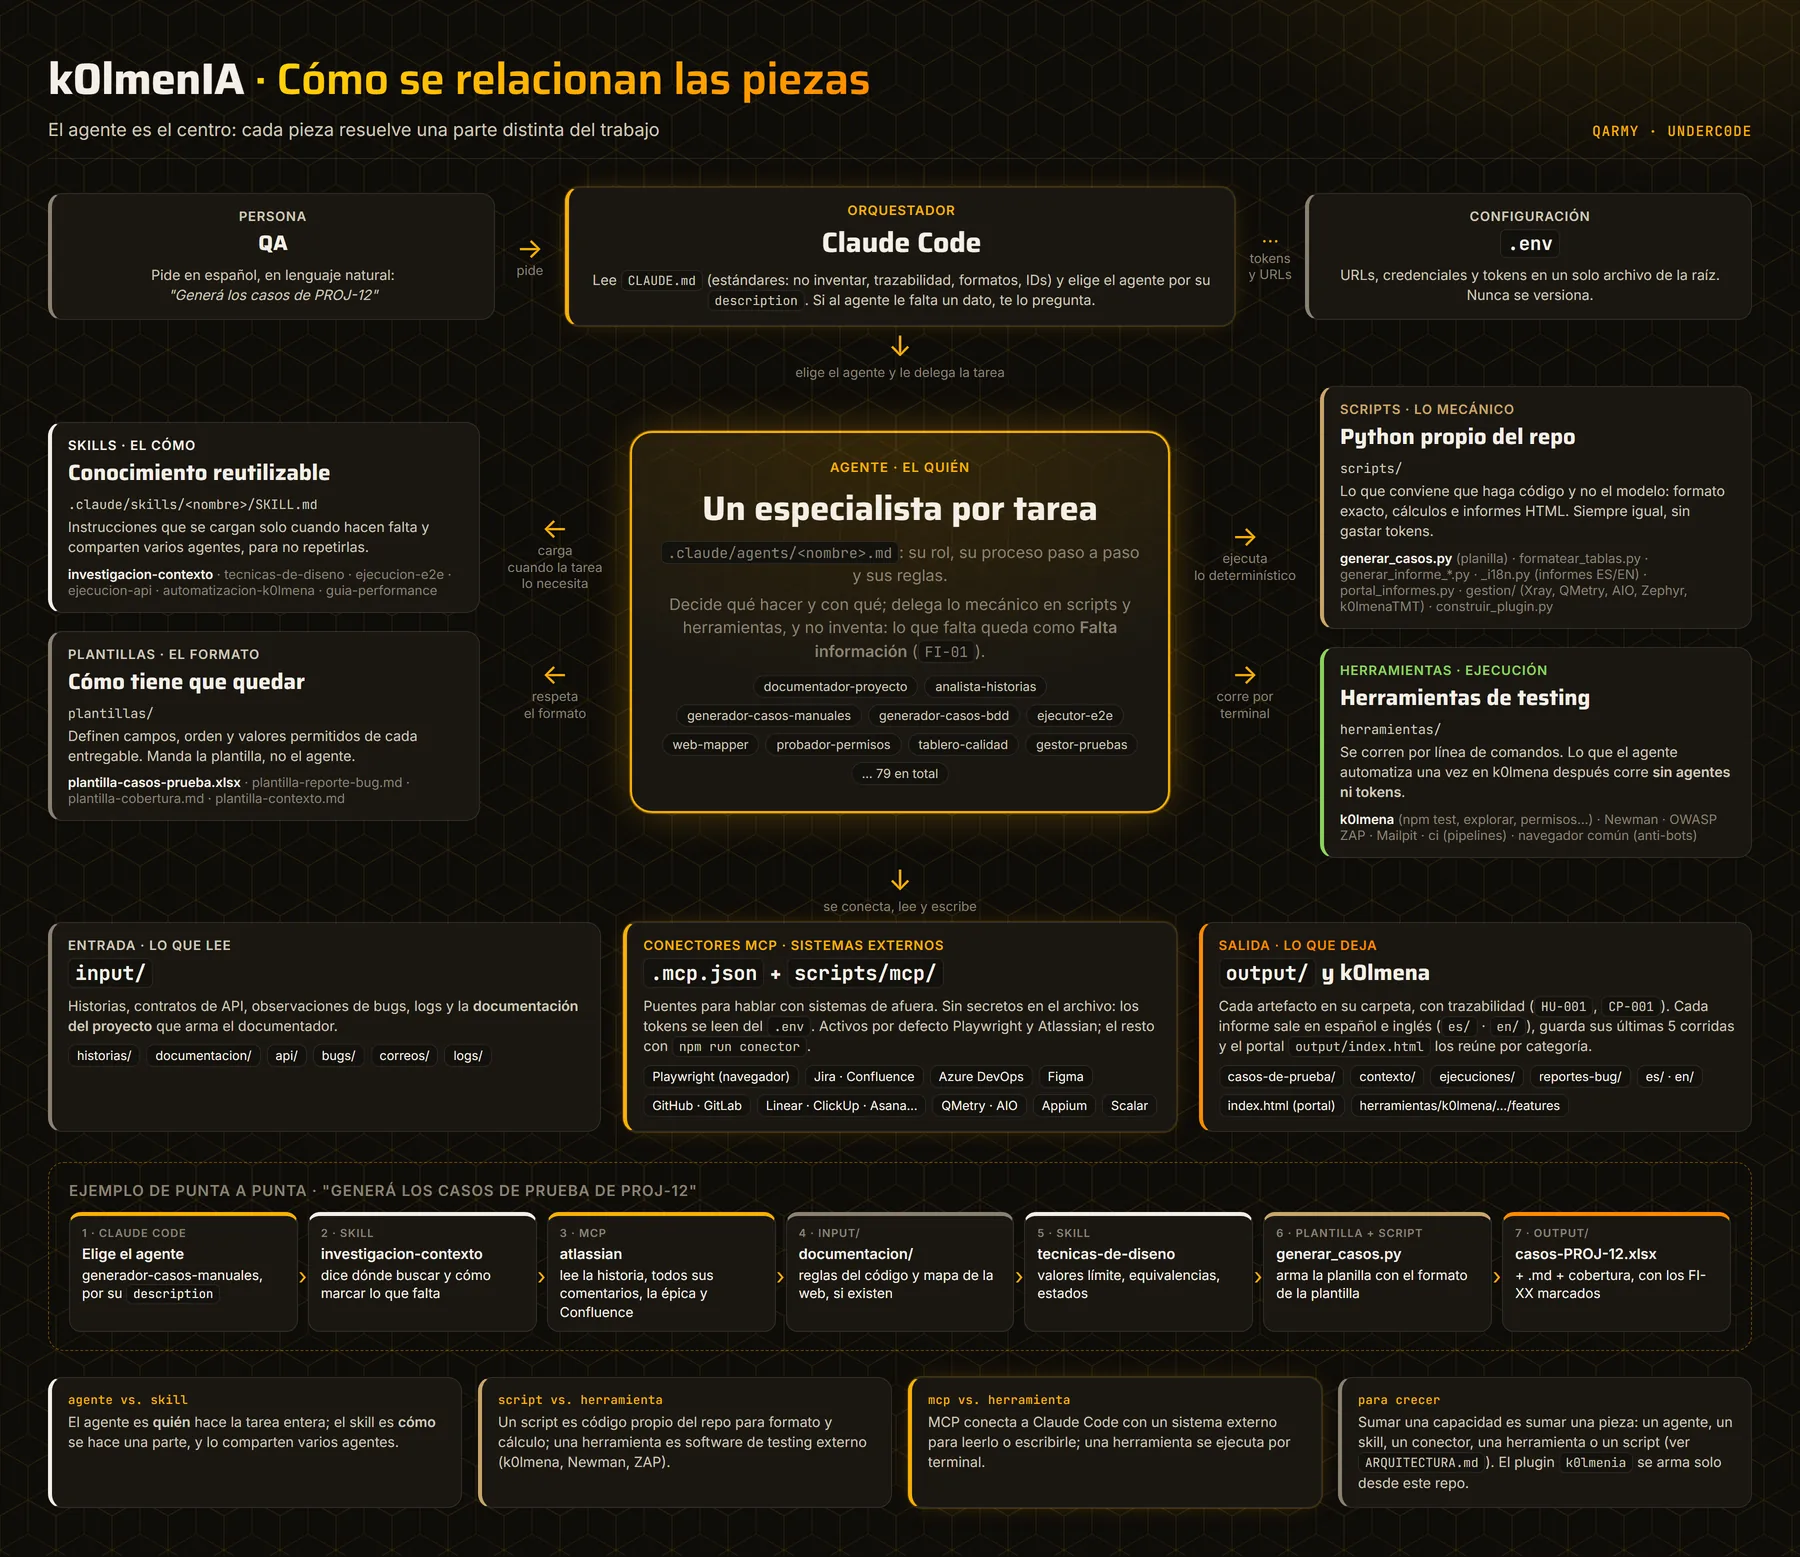
| Pieza | Qué es | Dónde |
|---|---|---|
| Claude Code | Orquestador: interpreta el pedido, elige el agente y aplica los estándares del proyecto (cortos a propósito: el detalle se lee a pedido). | CLAUDE.md · REFERENCIA.md (en el plugin: skill k0lmenia:estandares) |
| Agentes | El "quién": un especialista por tarea. | .claude/agents/ |
| Skills | El "cómo": conocimiento que se carga cuando hace falta (técnicas de diseño, ejecución E2E y de API, convenciones de k0lmena). | .claude/skills/ |
| Plantillas y scripts | Formato de salida (planilla de casos, cobertura, bug) y reportes HTML determinísticos. | plantillas/ · scripts/ |
| Integración de gestión | gestion.py con un adaptador por herramienta: Xray Cloud, Xray Server/DC, QTM4J, AIO Tests, Zephyr Scale y k0lmenaTMT (por su server MCP, sin el modelo). Azure DevOps va por su conector MCP. | scripts/gestion/ |
| Conectores MCP | Playwright y Atlassian (Jira y Confluence) activos; Azure DevOps, Figma, GitHub, GitLab, Linear, ClickUp, monday.com, Asana, Trello, Notion, YouTrack, Shortcut, Appium, QMetry, AIO Tests y k0lmenaTMT listos para habilitar. Versiones fijas, sin secretos en el archivo. | .mcp.json |
| Herramientas | Newman para colecciones de Postman y k0lmena para web, API, mobile y performance (con el navegador común para apps con protección anti-bots), más plantillas de CI. | herramientas/ |
| Informes y portal | Cada informe en español e inglés (es/ y en/) y el portal con categorías e historial. | scripts/_i18n.py · scripts/i18n/ · output/index.html |
| Plugin | El mismo K0lmenIA, instalable en cualquier proyecto. El comando k0lmenia reemplaza a npm run; el código queda en el plugin y los datos en el proyecto. | bin/k0lmenia · scripts/construir_plugin.py · rama plugin |
| Entrada y salida | Insumos del usuario y artefactos generados, ordenados por tipo. | input/ · output/ |
Cómo se usa
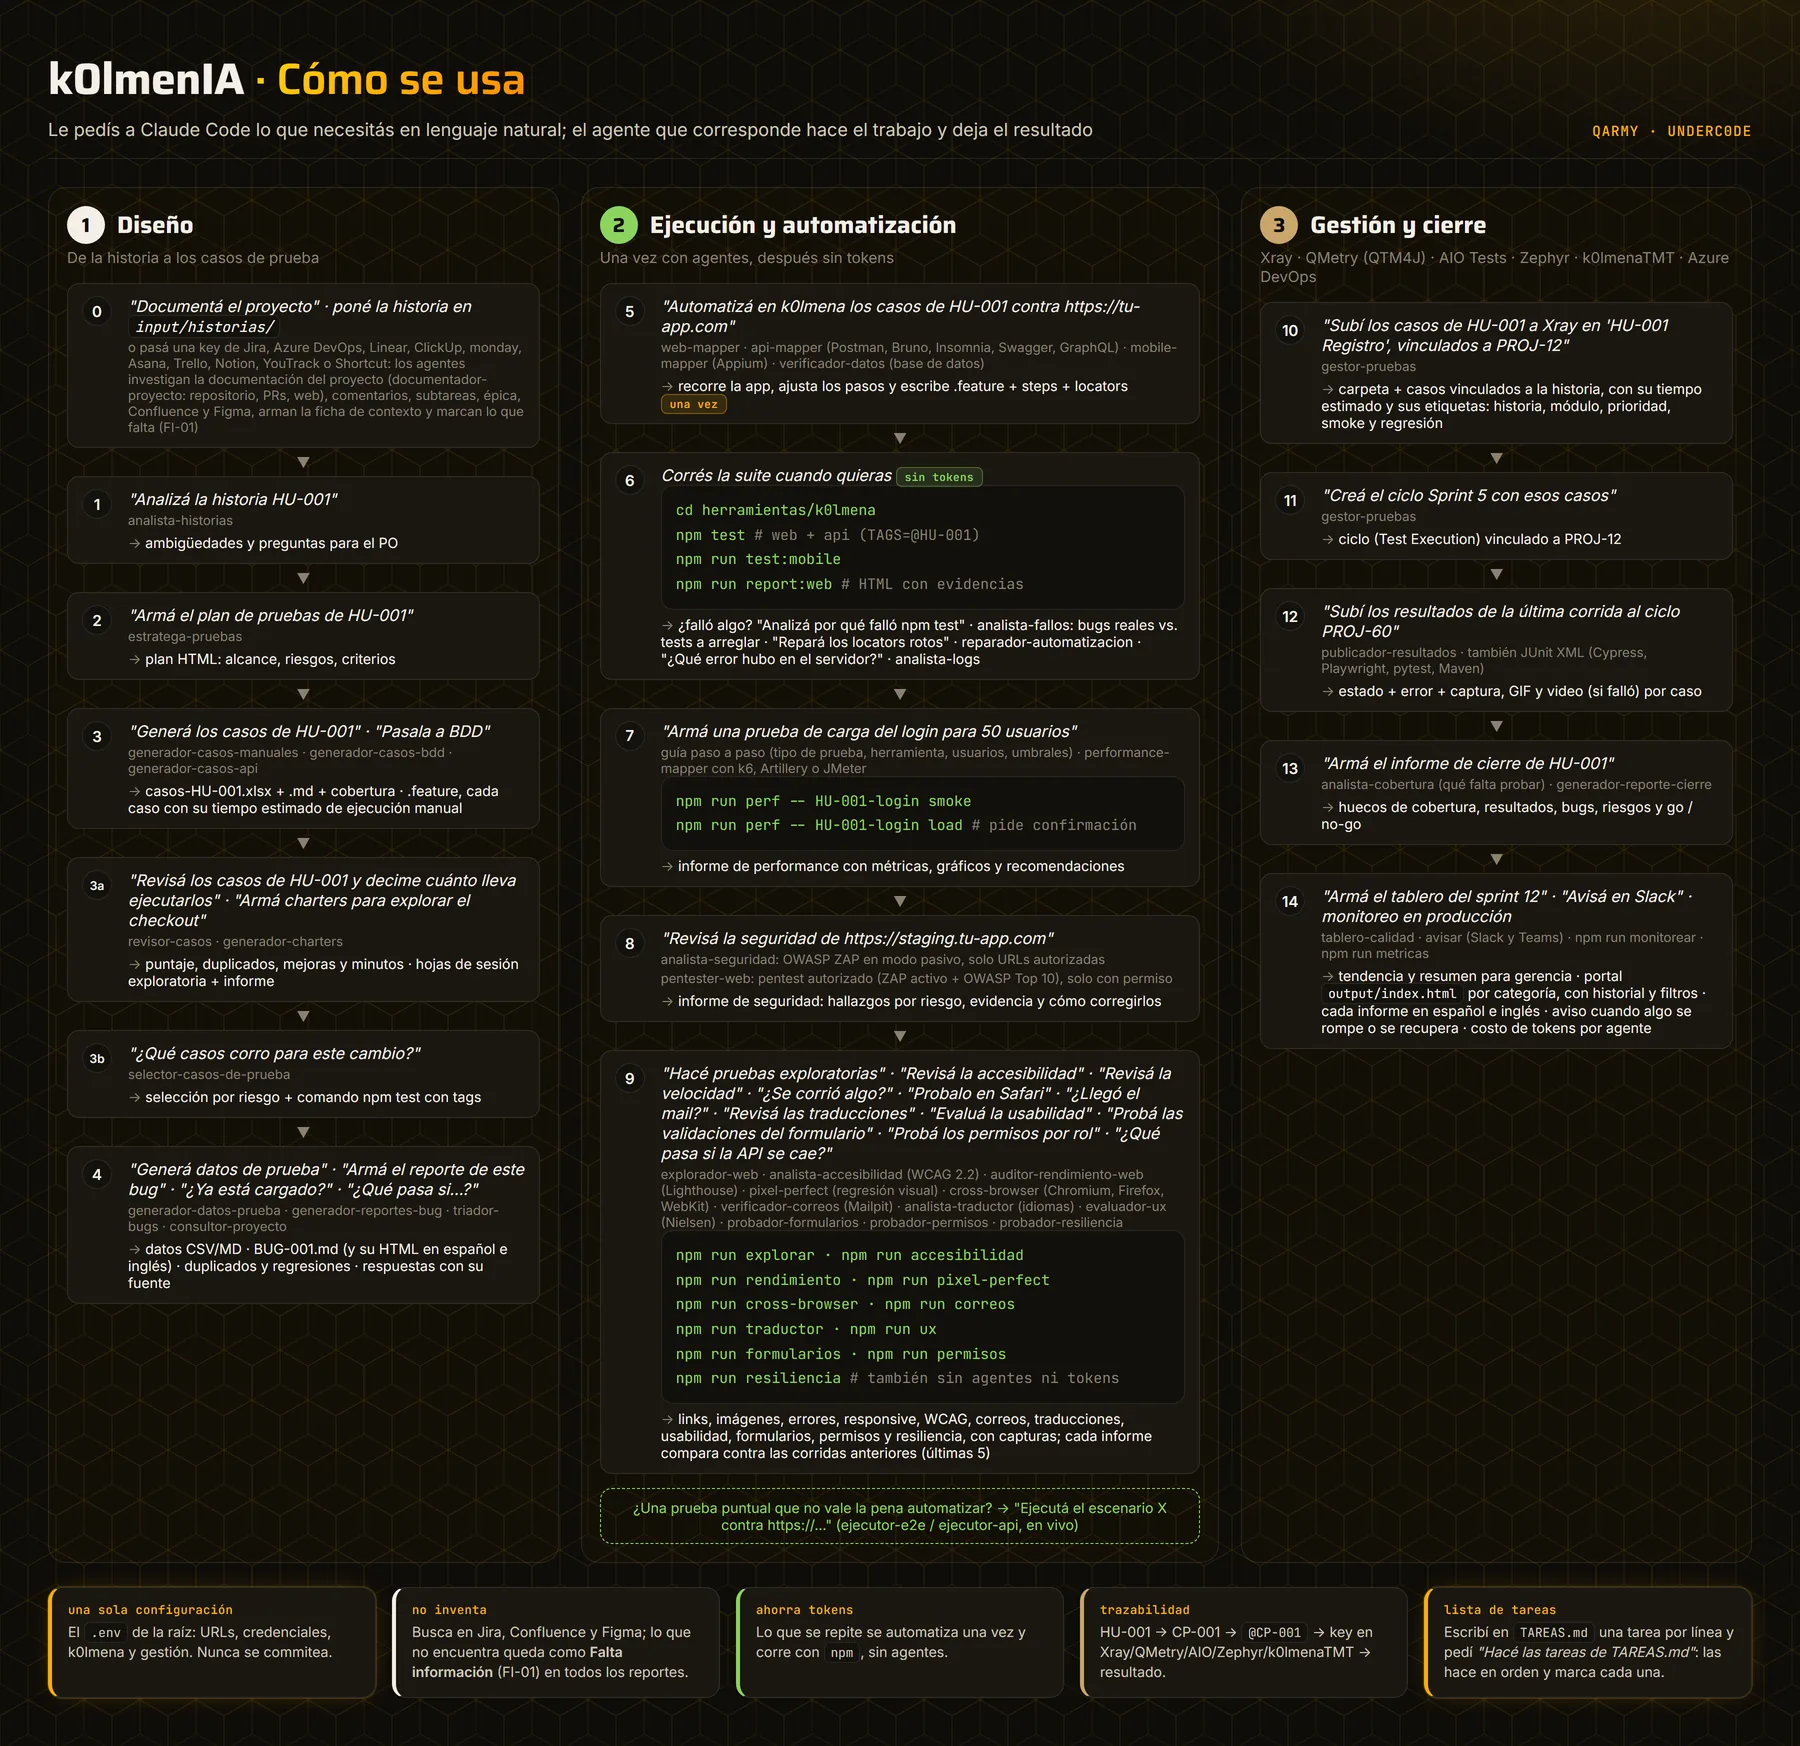
- Poné tus insumosPedí "Documentá el proyecto" para juntar el contexto del repositorio, las historias y la web en
input/documentacion/; poné lo demás eninput/, o pasá una key de Jira, una página de Confluence o un link de Figma con el conector activo. Los agentes investigan el contexto completo y marcan lo que falta (FI-01). - Pedí en lenguaje naturalClaude Code elige el agente. También podés nombrarlo: "usá el web-mapper para…".
- Revisá el resultadoEn
output/o enherramientas/k0lmena/. - Automatizá lo que se repiteY corrélo con
npm testtodas las veces que quieras, sin tokens.
Lista de tareas. Para encargar varias cosas de una vez, escribí en TAREAS.md (en la raíz) una tarea por línea, con su casilla (- [ ] Escribir los casos manuales de la HU-001), y pedí "Hacé las tareas de TAREAS.md". Claude las lee todas, te pregunta lo que necesita antes de empezar, las hace en orden y marca cada una: - [x] con dónde quedó el resultado, o - [!] con lo que le falta. Antes de escribir en Jira o en la herramienta de gestión, pide confirmación.
| # | Le pedís | Obtenés |
|---|---|---|
| 0 | "Documentá el proyecto" · "Juntá el contexto de PROJ-12" | Base del proyecto + dossier de la historia en input/documentacion/ |
| 1 | "Investigá el contexto de PROJ-12" | Ficha de contexto + Falta información |
| 2 | "Analizá la historia HU-001" | Ambigüedades y preguntas para el PO |
| 3 | "Armá el plan de pruebas de HU-001" | Plan HTML |
| 4 | "Generá los casos de HU-001" | casos-HU-001.xlsx + cobertura |
| 5 | "Subí los casos a Xray en 'HU-001 Registro', vinculados a PROJ-12, y creá el ciclo Sprint 5" | Casos y ciclo en Xray |
| 6 | "Automatizá en k0lmena los casos de HU-001 contra https://tu-app.com" | .feature + steps + locators |
| 7 | npm test · npm run report:web | Reporte HTML con evidencias |
| 8 | "Subí los resultados al ciclo del Sprint 5" | Estados y evidencias en Xray |
| 9 | "Armá una prueba de carga del login para 20 usuarios" | Script k6/Artillery/JMeter + reporte HTML |
| 10 | "¿Qué casos corro para el PR #42?" | Selección por riesgo + comando npm test con tags |
| 11 | "Corré una regresión visual de https://tu-app.com" · "Probá HU-003 en Chrome, Firefox y Safari" | Qué se corrió y cuántos px · matriz por navegador |
| 12 | "Repará los tests que fallaron por locators" | Locators nuevos aplicados y verificados |
| 13 | "Verificá que llegue el mail de bienvenida a [email protected]" · "Revisá las traducciones del sitio en inglés y portugués" | Correos revisados contra lo esperado · porcentaje traducido por idioma |
| 14 | "¿Este bug ya está cargado en Jira?" · "¿Qué pasa si un usuario bloqueado intenta pagar?" | Duplicados y regresiones · respuesta con su fuente |
| 15 | "Probá los permisos de admin, operador e invitado" · "¿Qué ve el usuario si la API se cae?" | Matriz rol × ruta · matriz página × escenario |
| 16 | "Armá el informe de cierre de HU-001" | Go / no-go |
| 17 | "Armá el tablero del sprint 12" · "Avisá en Slack el resultado" | Tendencia y resumen para gerencia · aviso en Slack o Teams |
Agentes
Claude Code elige el agente según lo que pidas. Están en .claude/agents/ y se agrupan en cuatro familias. El catálogo completo (cuándo usar cada uno, pedido de ejemplo, entradas, salidas y qué confirma) está en AGENTES.md.
Análisis y diseño
documentador-proyecto
Documentación del proyecto
Lightanalista-historias
Análisis de historias
Lightestratega-pruebas
Plan de pruebas
Proestratega-proyecto
Estrategia de pruebas del proyecto
Progenerador-casos-manuales
Casos de prueba manuales
Lightgenerador-casos-bdd
Escenarios BDD
Lightgenerador-casos-api
Casos de prueba de API
Progenerador-datos-prueba
Datos de prueba
Proselector-casos-de-prueba
Selección de casos por cambio
Prorevisor-casos
Revisión de casos
Lightgenerador-charters
Pruebas exploratorias por sesiones
Protriador-bugs
Triage de bugs
Lightanalista-causa-raiz
Causa raíz en el código
Proconsultor-proyecto
Consultas sobre el producto
Proguia-onboarding
Onboarding de QA
Empresainvestigador-proyecto
Relevamiento del proyecto
Proredactor-manual
Manuales de usuario
Progenerador-reportes-bug
Reportes de bug
Proanonimizador-datos
Anonimización de datos
Promapa-de-riesgo
Mapa de riesgo
Proanalista-flujos-reales
Flujos reales de los usuarios
Proanalista-reuniones
Análisis de reuniones
ProEjecución en vivo
usa tokens en cada corridaejecutor-e2e
Ejecución E2E
Lightejecutor-api
Ejecución de APIs
Lightexplorador-web
Exploración del sitio
Proanalista-accesibilidad
Accesibilidad
Proauditor-rendimiento-web
Velocidad de carga
Propixel-perfect
Regresión visual
Procross-browser
Compatibilidad entre navegadores
Proverificador-correos
Correos de la app
Proanalista-traductor
Traducciones e i18n
Proevaluador-ux
Usabilidad
Proprobador-permisos
Permisos por rol
Proprobador-resiliencia
Resiliencia ante fallas
Proprobador-formularios
Validación de formularios
Progenerador-reporte-html
Reporte de ejecución
Progenerador-reporte-cierre
Informe de cierre
Protablero-calidad
Tablero de calidad
Empresaanalista-metricas
Métricas de QA
Empresaanalista-cobertura
Matriz de cobertura
Proprobador-streaming
Streaming de video
Proprobador-onvif
Cámaras ONVIF
Procalidad-imagen
Calidad de imagen
Proverificador-grabaciones
Grabaciones de cámaras
Proanalista-seguridad-camaras
Seguridad de cámaras
Proprobador-salesforce
Salesforce
Empresaprobador-billeteras
Billeteras y pagos
Proprobador-shopify
Shopify
Proprobador-wordpress
WordPress y WooCommerce
Proprobador-prestashop
PrestaShop
Proprobador-vtex
VTEX
Proprobador-sap
SAP
Empresaprobador-desktop
Apps de escritorio
Proprobador-mobile
Apps mobile
Proanalista-dependencias
Dependencias
Prorevisor-codigo
Revisión de código
Proanalista-codigo-seguro
Código seguro
Proprobador-ia
Funciones de IA
Proanalista-analytics
Analytics y píxeles
Proprobador-chatbot
Chatbots
Proprobador-mensajeria
Mensajería y eventos
Proprobador-soap
Servicios SOAP
Proprobador-scalar
APIs en Scalar
Proprobador-contratos
Contract testing
Proanalista-seo
SEO y GEO
Proprobador-datos
Datos y pipelines
Proprobador-dynamics
Dynamics 365 y CRM
Empresaprobador-blockchain
Blockchain y Web3
Proprobador-ivr
IVR y voicebots
Proprobador-juegos
Videojuegos
Proprobador-pos
Punto de venta
Proanalista-observabilidad
Observabilidad
Proprobador-busqueda
Búsqueda y relevancia
Proprobador-documentos
Documentos generados
Prorevisor-contenido
Textos y ortografía
Proanalista-mutacion
Mutation testing
Provirtualizador-servicios
Virtualización de servicios
Proprobador-api-fuzzing
Fuzzing de APIs
Proverificador-ambiente
Verificación de ambientes
Proanalista-produccion
Errores de producción
Proanalista-feedback-usuarios
Feedback de usuarios
Prorevisor-automatizacion
Revisión de automatización
Proprobador-notificaciones
Notificaciones
Proprobador-experimentos
Feature flags y A/B tests
Proauditor-evidencias
Evidencia para auditorías
Empresapresentador-resultados
Presentación de resultados
Empresadepurador-suite
Depuración de la suite
Proanalista-cobertura-codigo
Cobertura de código
Proprobador-seguridad-api
Seguridad de APIs
Proprobador-migraciones-bd
Migraciones de base de datos
ProAutomatización con k0lmena
después corre sin tokensweb-mapper
Automatización web
Lightapi-mapper
Automatización de APIs
Lightmobile-mapper
Automatización mobile
Properformance-mapper
Pruebas de performance
Proverificador-datos
Verificación en bases de datos
Proanalista-fallos
Análisis de fallos
Proanalista-logs
Logs del servidor
Proreparador-automatizacion
Reparación de automatización
Proanalista-seguridad
Seguridad web pasiva
Propentester-web
Pentest web
Promigrador-automatizacion
Migración de automatización
ProGestión de pruebas
gestor-pruebas
Gestión de pruebas
Lightpublicador-resultados
Publicación de resultados
Lightanalista-trazabilidad
Trazabilidad
EmpresaSkills: el cómo que usan los agentes
- investigacion-contexto
- tecnicas-de-diseno
- ejecucion-e2e
- ejecucion-api
- automatizacion-k0lmena
- guia-performance
- guia-pruebas
- base-conocimiento
- verificacion-streaming
- control-onvif
- calidad-de-imagen
- seguridad-camaras
- relevamiento-proyecto
- redaccion-manual
- pruebas-salesforce
- pruebas-tokens
- pruebas-billeteras
- pruebas-ecommerce
- pruebas-shopify
- pruebas-wordpress
- pruebas-prestashop
- pruebas-vtex
- pruebas-sap
- pruebas-desktop
- pruebas-mobile
- analisis-dependencias
- codigo-seguro
- revision-codigo
- pruebas-ia
- empezar
- pruebas-analytics
- pruebas-chatbots
- estrategia-proyecto
- metricas-qa
- analisis-causa-raiz
- flujo-historia
- flujo-bug
- flujo-release
- flujo-pr
- flujo-sprint
- flujo-post-release
- flujo-auditoria
- resumen-diario
- mapa-riesgo
- depuracion-suite
- flujos-reales
- cobertura-codigo
- seguridad-api
- pruebas-migraciones
- analisis-reuniones
- virtualizacion-servicios
- pruebas-fuzzing-api
- verificacion-ambiente
- analisis-produccion
- analisis-feedback
- trazabilidad-herramientas
- migracion-automatizacion
- revision-automatizacion
- anonimizacion-datos
- pruebas-notificaciones
- pruebas-experimentos
- refinamiento-tres-amigos
- evidencias-auditoria
- presentacion-resultados
- pruebas-async
- pruebas-graphql
- pruebas-grpc
- pruebas-soap
- pruebas-scalar
- pruebas-contratos
- pruebas-seo
- pruebas-datos
- pruebas-dynamics
- pruebas-blockchain
- pruebas-ivr
- pruebas-juegos
- pruebas-pos
- pruebas-observabilidad
- pruebas-busqueda
- pruebas-documentos
- pruebas-contenido
- pruebas-mutacion
- documentacion-proyecto
- pruebas-exploratorias
- pruebas-resiliencia
- redaccion-casos-manuales
- pruebas-accesibilidad
Requisitos
Instalá solo lo que vayas a usar.
| Para… | Necesitás |
|---|---|
| Usar los agentes | Claude Code y una cuenta de Claude (Pro, Max, Team o Enterprise) o acceso por API de Anthropic. VS Code recomendado. |
| Casos, reportes y gestión | Python 3 con openpyxl, tabulate y requests. |
| Ejecutar E2E en vivo | Node.js 18+ y los navegadores de Playwright. |
| Ejecutar colecciones de Postman | Newman. |
| Automatizar con k0lmena | Node.js 20+. |
| Automatizar mobile | Node.js 22+, JDK y Android SDK, o macOS con Xcode para iOS; o una cuenta de BrowserStack. |
Instalación
En cinco minutos tenés los agentes andando; k0lmena y el resto se suman cuando los necesites.
¿No querés clonar el repo? Instalalo como plugin de Claude Code en la carpeta de tu proyecto: mismos agentes, y las actualizaciones llegan con un comando.
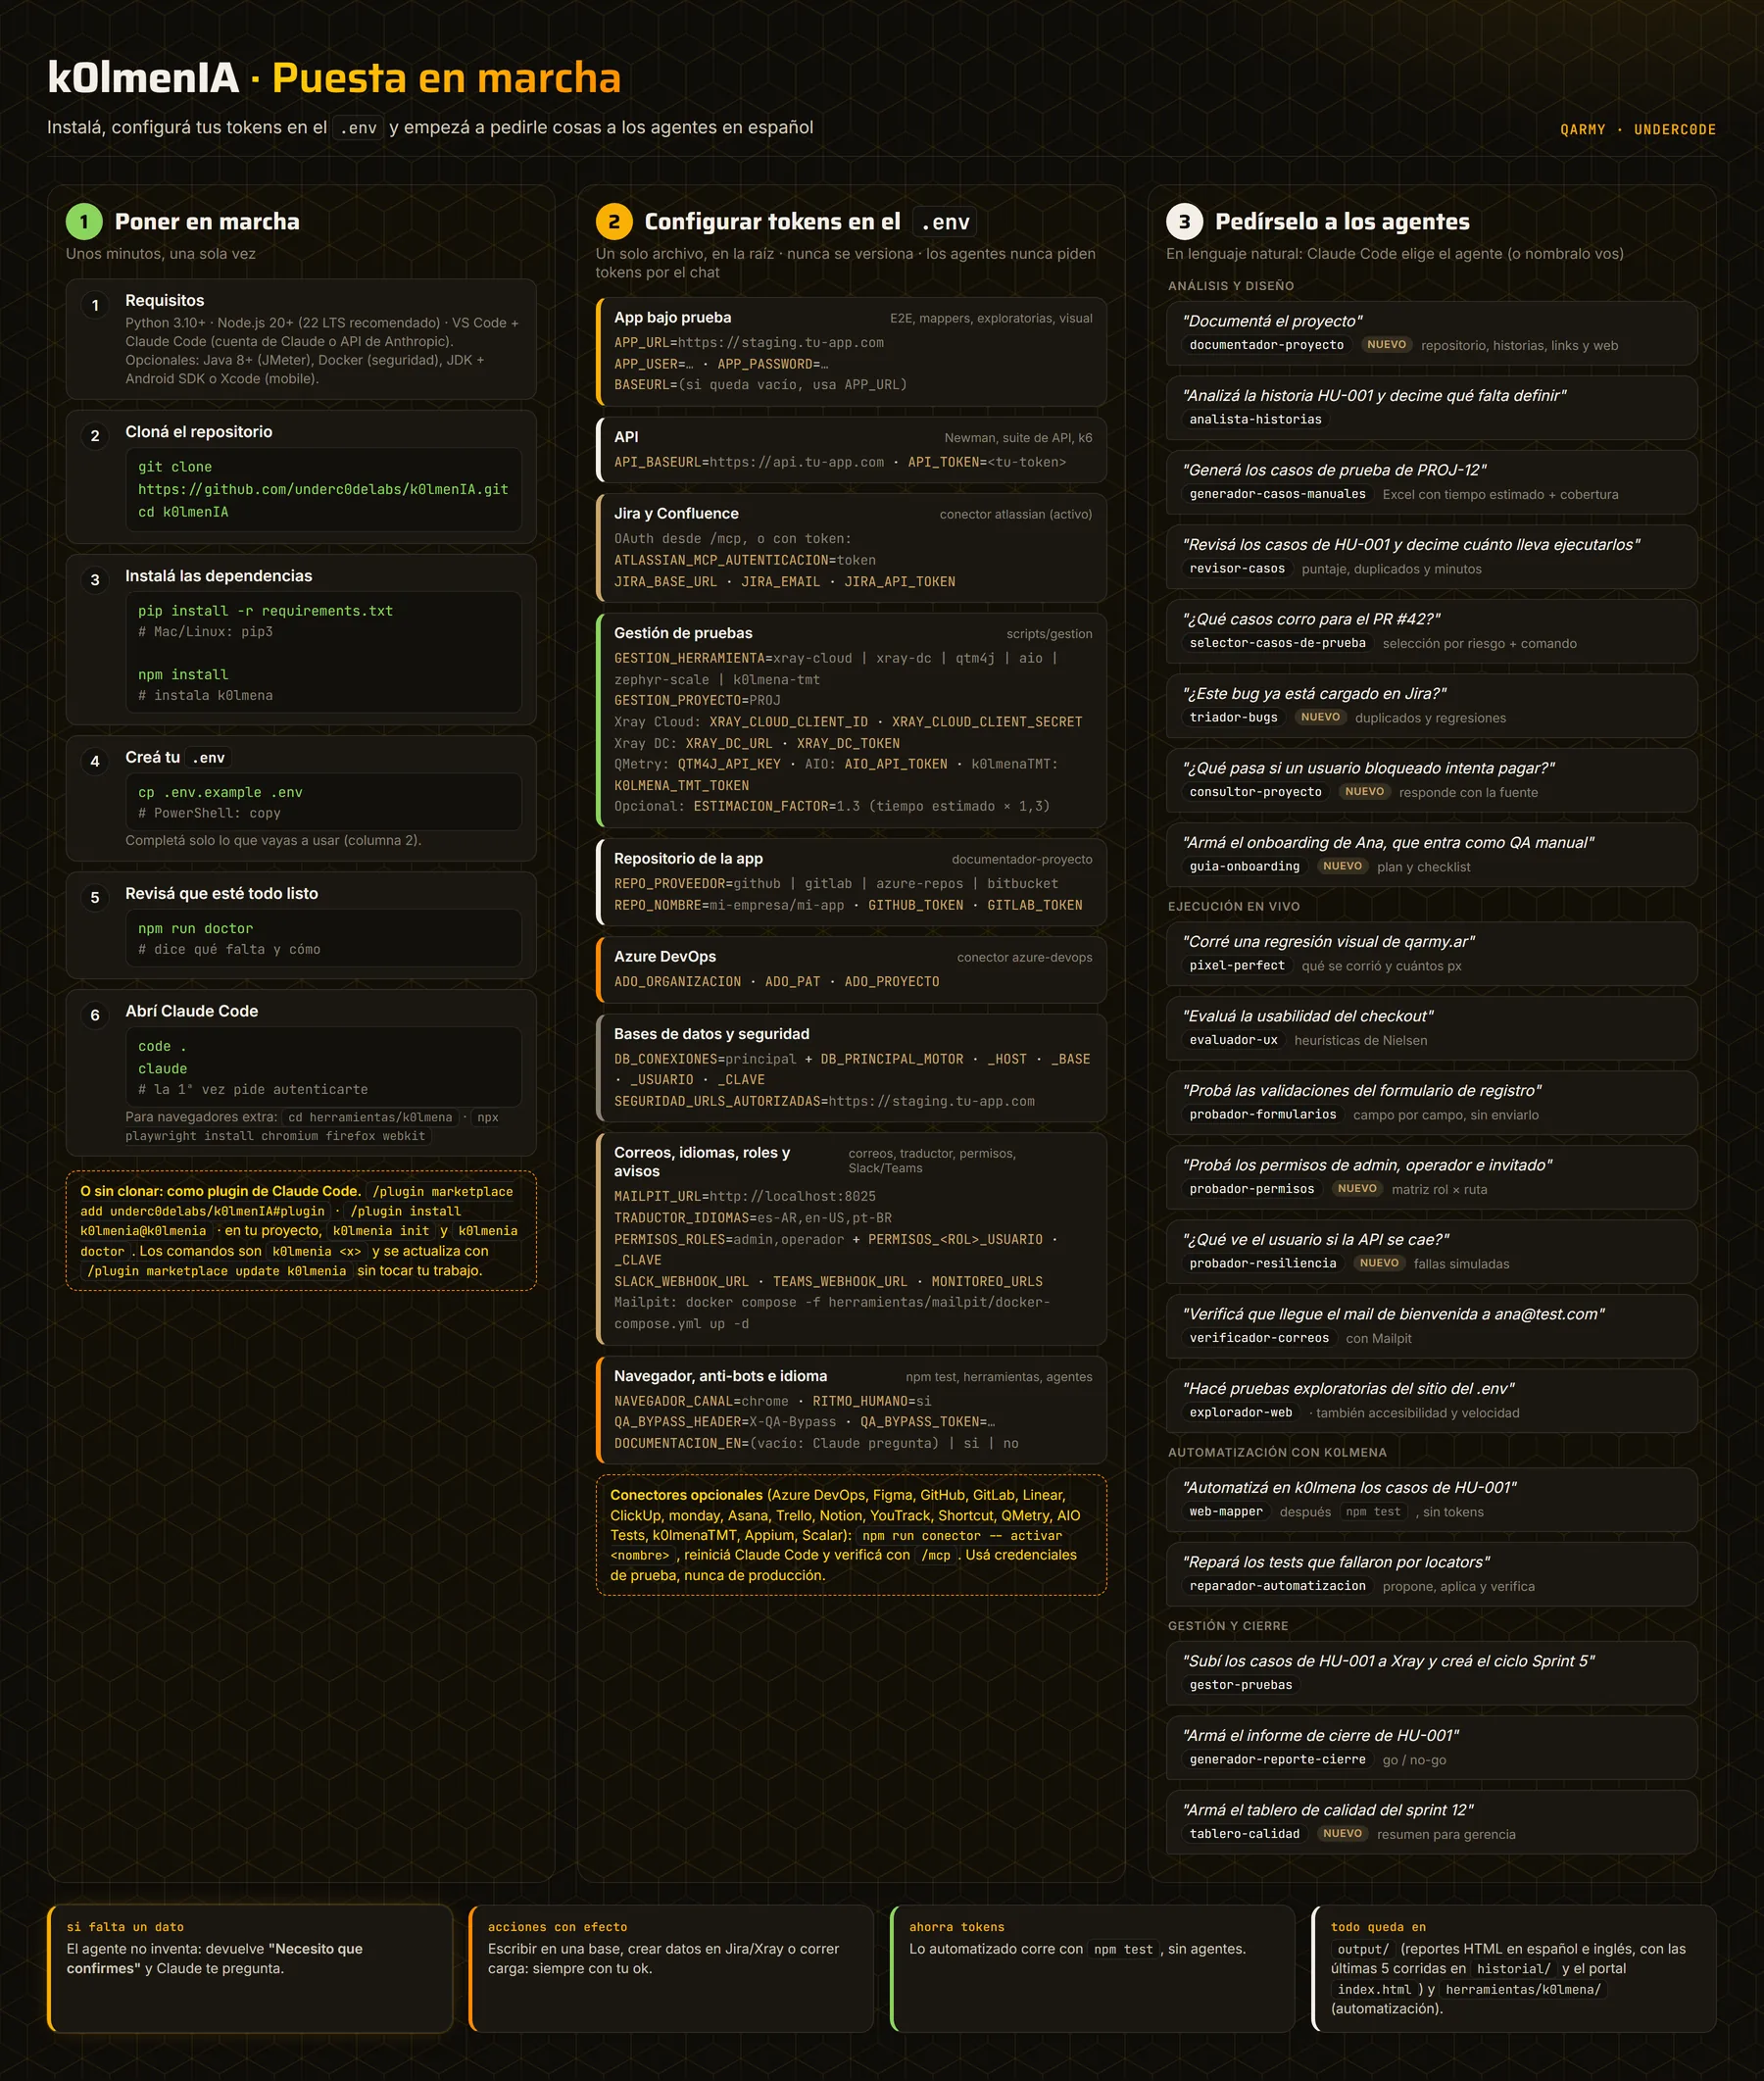
.env y pedidos de ejemplo · hacé clic para ver en tamaño completo- Instalá Claude Code
En Windows, seguí la guía oficial.
curl -fsSL https://claude.ai/install.sh | bash # macOS / Linux npm install -g @anthropic-ai/claude-code # alternativa (con Node.js 22 LTS cubrís todo) claude --version - Cloná el repositorio
En Windows el comando es
git clone https://github.com/underc0delabs/k0lmenIA.git cd k0lmenIA # o la carpeta donde lo clonaste pip install -r requirements.txt # Mac/Linux: pip3 npm install # k0lmena cp .env.example .env # y completalo (PowerShell: copy)python; en Mac y Linux,python3ypip3(sipip3responde externally-managed-environment, usá un entorno virtual:python3 -m venv .venv). - Revisá que esté todo listo
npm run doctor # dice qué falta y cómo resolverlo npm run doctor -- --seccion env,integraciones # solo una parte · --rapido · --json - Abrí VS Code y lanzá Claude Code
code . claude # la primera vez pide autenticarte - Sumá lo opcional
npx playwright install                             # ejecución E2E en vivo
npm install -g newman                              # colecciones de Postman
cd herramientas/k0lmena
npx playwright install chromium               # + firefox webkit para el cross-browser
npm run bootstrap:k6                               # performance de APIs con k6
npm run bootstrap:jmeter                           # performance con JMeter (Java 8+)
Como plugin de Claude Code
El mismo K0lmenIA, instalado en la carpeta de cualquier proyecto, sin clonar este repo. Las actualizaciones llegan con un comando y nunca tocan tu trabajo.
- InstalaloUna sola vez, desde una terminal (o con
/pluginadentro de Claude Code):claude plugin marketplace add underc0delabs/k0lmenIA claude plugin install k0lmenia@k0lmenia - Escribí
/k0lmenia:empezarEn Claude Code, abierto en la carpeta de tu proyecto. Te prepara el proyecto (carpetas,.envy tu copia de k0lmena), revisa que tengas Python y Node, te ayuda a conectar tus herramientas y te propone la primera tarea. Si preferís hacerlo a mano:k0lmenia init # input/, output/, .env, .gitignore y tu copia de k0lmena (npm install) k0lmenia configurar # completa el .env con preguntas k0lmenia doctor # revisa que esté todo - Trabajá igual que siemprePedí en lenguaje natural. Los agentes se llaman
k0lmenia:<agente>(por ejemplok0lmenia:generador-casos-manuales), y al iniciar cada sesión un hook recuerda los estándares de K0lmenIA e instala las dependencias de Python.
Qué instala y dónde. El código (agentes, skills, scripts y herramientas) queda en la caché de Claude Code y se actualiza solo. En tu proyecto, k0lmenia init deja lo tuyo: input/ con los mismos ejemplos que el repo, output/ con los informes y el portal, el .env, TAREAS.md, tu copia de k0lmena y, en .claude/settings.json, los mismos permisos que el repo clonado. Nunca pisa un archivo que ya existe. Es igual que clonar el repo: solo no viajan la web y el PDF (están online), los tests del repo y los evals de los agentes.
El comando k0lmenia
Con el plugin habilitado, Claude Code lo deja en el PATH. Lo que en el repo es npm run <x> o python scripts/<x>.py, en el plugin es k0lmenia <x>.
| Comando | Qué hace |
|---|---|
k0lmenia init [--sin-npm] | Prepara el proyecto. Si ya estaba preparado, solo suma lo que falta: no pisa tu .env ni tus pruebas. |
k0lmenia actualizar | Actualiza el núcleo de k0lmena en tu proyecto (runner, framework y herramientas) sin tocar tus pruebas (features/, steps/, locators/, apps y scripts de performance). Si modificaste un archivo del framework, no se pisa: la versión nueva queda al lado como <archivo>.nuevo para que la compares. Al iniciar la sesión, Claude te avisa si hay una versión nueva. --sin-npm saltea la instalación de dependencias. |
k0lmenia <comando> [args] | Cualquier comando del repo: doctor, portal, explorar, accesibilidad, sast, login, ci… |
k0lmenia test[:web|:api|:mobile] | Las suites de k0lmena de tu proyecto (npm test). |
k0lmenia py <script.py> [args] | Un script de Python del plugin (scripts/… o herramientas/…). |
k0lmenia ayuda | La lista completa. |
Código y datos, separados
En el plugin (se actualiza)
Agentes, skills, scripts, plantillas y herramientas. Viven en la caché de Claude Code (~/.claude/plugins/).
En tu proyecto (no se toca)
input/, output/, .env, .auth/ y herramientas/ con tus pruebas automatizadas.
Actualizar
/plugin marketplace update k0lmenia, o la actualización automática en /plugin → Marketplaces (para marketplaces propios viene apagada).
Cómo llegan las actualizaciones
Este repo es donde se desarrolla. En cada push a main, el workflow plugin.yml arma el plugin (scripts/construir_plugin.py) y lo publica en la rama plugin, liviana y sin el historial del repo. El plugin no fija versión, así que cada publicación es una versión nueva: la recibís con /plugin marketplace update k0lmenia o sola, si activaste la actualización automática. La versión anterior se borra a los 14 días.
Personalizar y trabajar en equipo
- Un agente a tu medida: copialo a
.claude/agents/de tu proyecto. Esa copia le gana a la del plugin, pero deja de recibir las mejoras de ese agente. Lo que se pueda resolver con el.envo el CLAUDE.md de tu proyecto, mejor resolvelo ahí. - Para todo el equipo: declarás el marketplace y el plugin en el
.claude/settings.jsondel proyecto. Cada persona lo instala una vez y acepta el diálogo de confianza de la carpeta.
{
  "extraKnownMarketplaces": {"k0lmenia": {"source": {"source": "github", "repo": "underc0delabs/k0lmenIA", "ref": "plugin"}}},
  "enabledPlugins": {"k0lmenia@k0lmenia": true}
}Limitaciones. El plugin no puede traer la lista de comandos permitidos: la primera vez Claude pide aprobación para k0lmenia … (cada equipo la puede sumar en su .claude/settings.json). Si usás el plugin y el repo clonado en la misma carpeta, vas a ver los agentes dos veces (con y sin prefijo).
Configuración: el archivo .env
Hay un solo .env, en la raíz del repo (o de tu proyecto, si usás el plugin). Lo usan los agentes, k0lmena y los scripts de gestión. Está en .gitignore y la plantilla comentada es .env.example.
| Grupo | Variables | Para qué |
|---|---|---|
| App bajo prueba | APP_URL APP_USER APP_PASSWORD | Ejecución E2E y logins |
| API | API_TOKEN API_BASEURL GRAPHQL_URL | Newman, suite de API y k6 |
| Web | BASEURL BROWSER HEADLESS VIEWPORT_WIDTH VIEWPORT_HEIGHT LOCALE TIMEZONE | Navegador de la suite web (vacías: Chromium, Firefox y WebKit a 1366x768) |
| Ejecución | TAGS PARALLEL | Qué escenarios y cómo se corren |
| Evidencias | EVIDENCE (captura · ambos · off) VIDEO TRACE | Qué se adjunta al reporte |
| Auto-healing | K0LMENA_AUTO_HEALING | Recuperar locators rotos |
| Mobile | MOBILE_TARGET MOBILE_PLATFORM MOBILE_DEVICE_NAME MOBILE_APP MOBILE_UDID BROWSERSTACK_* | Dónde corre la suite mobile |
| Performance | PERF_VUS PERF_DURACION | Pisar la carga de los scripts k6 |
| Bases de datos | DB_CONEXIONES + DB_<NOMBRE>_MOTOR _HOST _PUERTO _BASE _USUARIO _CLAVE (o _URL) _ESCRITURA _PRODUCCION | Verificación en base de datos |
| Gestión | GESTION_HERRAMIENTA GESTION_PROYECTO + credenciales de la herramienta (Zephyr Scale: ZEPHYR_API_TOKEN ZEPHYR_API_URL y las de Jira; k0lmenaTMT: K0LMENA_TMT_TOKEN y el id numérico del proyecto) | Xray, QMetry, AIO Tests, Zephyr Scale y k0lmenaTMT |
| Navegador y anti-bots | NAVEGADOR_CANAL RITMO_HUMANO QA_BYPASS_HEADER QA_BYPASS_TOKEN QA_BYPASS_HOSTS | Chrome o Edge instalados, pausas y el header de excepción para apps con protección anti-bots |
| Idioma de la documentación | DOCUMENTACION_EN (vacío · si · no) | Contexto y documentación del proyecto también en inglés: vacío = Claude pregunta |
| Azure DevOps (MCP) | ADO_ORGANIZACION ADO_PAT ADO_PROYECTO | Boards, Wiki, Repos y Test Plans |
| Permisos por rol | PERMISOS_ROLES PERMISOS_<ROL>_USUARIO _CLAVE _TOKEN PERMISOS_LOGIN_URL | Roles que prueba el probador-permisos |
| Avisos | SLACK_WEBHOOK_URL TEAMS_WEBHOOK_URL | Avisos a Slack y Teams (scripts/avisar.py) |
| Monitoreo | MONITOREO_URLS MONITOREO_LINK | Monitoreo sintético (npm run monitorear) |
| Repositorio de la app | REPO_PROVEEDOR REPO_NOMBRE REPO_RAMA REPO_RUTA_LOCAL GITHUB_TOKEN GITLAB_URL GITLAB_TOKEN | Lo lee el documentador-proyecto (GitHub, GitLab, Azure Repos o Bitbucket, solo lectura) |
| Correos | MAILPIT_URL MAILPIT_USUARIO MAILPIT_CLAVE CORREO_TIMEOUT_S | Buzón de prueba Mailpit (verificador-correos y steps de correo) |
| Idiomas | TRADUCTOR_IDIOMAS TRADUCTOR_URL_IDIOMA | Idiomas a revisar y cómo se cambia de idioma (analista-traductor) |
| Tiempo estimado | ESTIMACION_FACTOR GESTION_TIEMPO_NATIVO | Opcionales: multiplicar el tiempo estimado de los casos (por ejemplo 1,3) y no usar el campo de tiempo de la herramienta de gestión (0) |
Usá credenciales de un entorno de prueba, nunca de producción. Los agentes leen los secretos del .env: nunca pegues un token en el chat ni lo escribas en un archivo versionado.
Carpetas de entrada
| Carpeta | Qué va |
|---|---|
input/historias/ | Historias de usuario con sus criterios de aceptación (HU-001.md, …). |
input/documentacion/ | Documentación del proyecto: la que arma el documentador-proyecto (índice, base del proyecto, dossier por historia) y la que agregues a mano. No se versiona. |
input/api/ | Contratos, colecciones de Postman y environments. |
input/bugs/ | Observaciones sueltas de errores para convertir en reportes. |
input/correos/ | Lo que tiene que llegar por mail en cada caso (espera-HU-001.json, para el verificador-correos). |
input/logs/ | Logs de la aplicación para el analista-logs (app.log, access.log). No se versionan. |
Documentación del proyecto
El documentador-proyecto junta el contexto real del proyecto y lo deja en input/documentacion/, para que el analista, el estratega y los generadores de casos trabajen sobre lo que existe y no sobre suposiciones. Es de solo lectura: no escribe en el repositorio, en Jira ni en la aplicación.
Qué lee
| Fuente | Qué extrae |
|---|---|
| Repositorio de la app | README y docs; validaciones y límites, mensajes de error, estados y transiciones, roles y permisos, rutas y pantallas, contratos de API; y los PRs y commits de cada historia, con sus comentarios de revisión. |
| Historias | Jira o Azure DevOps con todos sus comentarios, subtareas, épica, historias hermanas, issues y bugs vinculados (skill investigacion-contexto). |
| Links | Confluence, la Wiki de Azure DevOps y Figma con su conector; las páginas públicas con una lectura rápida. Los privados sin conector (Google Docs, SharePoint, Notion) quedan listados como No accesible, con qué haría falta para leerlos. |
| La aplicación | npm run mapa-funcional: cada página con sus secciones, menús, formularios (cada campo con su etiqueta, tipo, obligatorio, largos, mínimos, máximos, patrón y opciones), botones, mensajes visibles y tablas. Solo GET, sin login y sin enviar nada. |
Qué deja
| Archivo | Contenido |
|---|---|
INDICE.md | Qué documentación hay, de qué fuentes sale, cuándo se actualizó y si conviene revisarla (scripts/indice_documentacion.py). |
proyecto/ | Resumen del producto (módulos, roles, glosario), repositorio, reglas de negocio, mensajes, estados y permisos, mapa funcional y links. |
api/ | Los contratos de API encontrados en el repositorio y su resumen. |
historias/<HU o key>/dossier.md | Todo lo de una historia: criterios, decisiones en comentarios, links, PRs y código tocado, pantallas, API, contradicciones entre fuentes y pistas para probar. |
Cada dato lleva su fuente (src/pagos/validaciones.ts:42, el PR, el comentario con autor y fecha). Lo que sale del código o de la aplicación queda como "así funciona hoy", no como requisito: si contradice a la historia, el skill investigacion-contexto lo registra como FI-XX. Ese skill lee primero el índice y el dossier, así que lo aprovechan todos los agentes que investigan una historia. input/documentacion/ no se versiona.
Conectar el repositorio
| Proveedor | Conector | Qué configurar |
|---|---|---|
| GitHub | github (remoto, solo lectura) | GITHUB_TOKEN fine-grained de solo lectura. No soporta GitHub Enterprise Server. |
| GitLab | gitlab (/api/v4/mcp) | GITLAB_URL; tu cuenta (OAuth) o GITLAB_TOKEN fine-grained. GitLab.com o 19.5+. |
| Azure Repos | azure-devops | El dominio repositories viene por defecto; el PAT necesita Code (Read). |
| Bitbucket Cloud | atlassian | ATLASSIAN_MCP_AUTENTICACION=token y un API token con permisos de Bitbucket. |
En el .env: REPO_PROVEEDOR, REPO_NOMBRE (uno o varios, separados por coma), REPO_RAMA y, opcional, REPO_RUTA_LOCAL (un clon local: el código se lee de ahí, más rápido y sin gastar tokens del conector). Después, npm run conector -- activar github (o gitlab) y reiniciá Claude Code.
Investigación de contexto y "Falta información"
Antes de analizar, planificar, escribir casos o automatizar, los agentes investigan el contexto completo de la historia en lugar de suponer. Lo que no encuentran en ninguna fuente queda marcado como Falta información en todos los reportes.
Dónde buscan
| Fuente | Qué revisan |
|---|---|
| Documentación del proyecto | Primero. El índice y el dossier de la historia que arma el documentador-proyecto en input/documentacion/: si está vigente, no se vuelve a recorrer Jira. |
| Historia de Jira | Descripción, criterios, estado, labels, componentes y adjuntos. |
| Comentarios | Todos. Las decisiones que se tomaron después ("acordamos que el límite es 50") reemplazan a la descripción, citando quién y cuándo. |
| Subtareas, épica e issues vinculados | Detalle de cada subtarea, reglas generales e historias hermanas de la épica, dependencias y bugs conocidos del flujo. |
| Confluence | Páginas enlazadas o, si no hay, las más relevantes del espacio del proyecto. |
| Figma | Textos exactos, mensajes de error, estados y campos obligatorios. |
Contratos e input/ | Swagger, Postman y documentación local. |
El resultado es una ficha de contexto reutilizable, output/contexto/contexto-HU-XXX.md: fuentes consultadas, hallazgos por criterio, decisiones, contradicciones y lo que falta. Si la historia no cambió, los demás agentes la reusan sin volver a investigar. Si un conector no está activo, la fuente queda como "No disponible" en lugar de suponerla.
Falta información (FI-XX)
Cada dato que no aparece en ninguna fuente (o aparece contradictorio) recibe un ID por historia, con qué falta, dónde se buscó, a qué afecta y la pregunta para el PO. El mismo ID viaja a todos los artefactos. La app no es fuente de requisitos: si el resultado esperado depende de un dato faltante, el escenario no se "acomoda" a lo que hace la aplicación; se automatiza con el supuesto marcado o queda @bloqueado hasta que el PO responda.
| Dónde | Cómo se ve |
|---|---|
| Planilla de casos | Casos resaltados en ámbar, etiqueta @falta-info, detalle en Comentarios y hoja Falta información. |
| Análisis y coberturas | Sección Falta información; criterios con cobertura Parcial (falta información). |
.feature de k0lmena | Tags @falta-info @FI-01 y comentario # FALTA INFORMACIÓN (FI-01): …. |
| Reporte de mapeo | Estado Falta información. El mapper no usa la app para completar el dato: lo que muestra la app queda como observación. |
| Reportes de k0lmena y de ejecución | Nota visible en el escenario y aviso en el resumen. |
| Informe de cierre | Sección Falta información; los ítems abiertos cuentan como riesgo para el go/no-go. |
| Xray · QMetry · AIO · Zephyr · k0lmenaTMT | El comentario del resultado (en k0lmenaTMT, el resultado.txt de la ejecución) aclara que el caso depende de información faltante. |
Diseño y ejecución
Qué pedir, qué hace cada agente y qué deja.
Analizar una historia analista-historias
Revisa cada criterio y entrega analisis-HU-001.md con ambigüedades, vacíos, riesgos, casos no contemplados y preguntas para el PO.
Armar el plan de pruebas estratega-pruebas
Dashboard HTML con alcance, objetivos, tipos de prueba, riesgos, datos y entorno, y criterios de entrada y salida.
Generar casos manuales generador-casos-manuales
Entrega casos-HU-001.xlsx, casos-HU-001.md y casos-HU-001-cobertura.md. Cubre camino feliz, negativos, bordes y validaciones. Cada caso lleva su tiempo estimado de ejecución manual, con el total al pie (ver Revisión de casos y tiempo estimado). Esa planilla es la que después se sube a la herramienta de gestión o se automatiza.
Generar escenarios BDD generador-casos-bdd
Genera HU-001-<slug>.feature, con un tag @CP-XXX por escenario, y HU-001-cobertura.md, con el tiempo estimado si se ejecutan a mano.
Generar casos de API generador-casos-api
Tabla resumen y detalle por caso: método, endpoint, headers, body, status y schema esperado.
Datos de prueba y bugs generador-datos-prueba generador-reportes-bug
Datos válidos, inválidos y de borde. Los bugs siguen plantillas/plantilla-reporte-bug.md (editala para usar tu formato) y marcan lo que falta en vez de inventarlo.
Ejecutar en vivo ejecutor-e2e ejecutor-api usa tokens
El ejecutor E2E pregunta si querés ver el navegador, ejecuta con Playwright MCP, saca evidencia y genera reporte-HU-001-<fecha-hora>.html. Para recorrer un sitio entero buscando fallas, está el explorador-web (ver Pruebas exploratorias). El de API corre la colección con Newman. Ideal para pruebas puntuales: lo que se repite conviene automatizarlo.
Reportes e informe de cierre generador-reporte-html generador-reporte-cierre
Dashboards con indicadores, gráficos y detalle; el informe de cierre suma bugs abiertos, riesgos y la recomendación go/no-go.
Automatización con k0lmena
El framework integrado en herramientas/k0lmena/. Un agente mapper recorre la aplicación una sola vez y escribe la automatización; desde ahí la suite corre con npm, sin agentes y sin tokens.
Web
Playwright + Cucumber, video, trace y GIF. Con K0LMENA_AUTO_HEALING=on recupera locators rotos.
API
axios + Cucumber con steps genéricos en español: no hace falta programar.
Mobile
WebdriverIO + Appium en dispositivo, emulador o BrowserStack.
Performance
k6 para APIs, Artillery + Playwright para flujos web y JMeter para quien ya trabaja con .jmx.
Las carpetas de k0lmena vienen vacías: todo lo que hay adentro lo generan los mappers para tu aplicación.
web-mapper
- Lee los casos (manuales o BDD).
- Navega la web real con Playwright MCP y comprueba que cada paso se puede ejecutar.
- Genera
web/features/HU-001-<slug>.feature,web/steps/HU-001.steps.tsyweb/locators/HU-001.locators.ts, reutilizando steps existentes. - Valida con
npm run test:weby dejaoutput/mapeos/mapeo-HU-001-web.md.
Si un paso no se puede ejecutar, el escenario queda @bloqueado con el motivo y no corre hasta que se resuelva.
api-mapper
Lee Postman (v2.x) o Swagger/OpenAPI, te deja elegir los endpoints, diseña escenarios positivos, negativos y de autorización, los verifica contra la API real y escribe los .feature con los steps genéricos. Antes de un POST, PUT, PATCH o DELETE pide autorización.
mobile-mapper
Necesita el conector Appium MCP y la app en mobile/apps/ (no se versiona). Después la suite corre sin MCP según MOBILE_TARGET:
| Destino | Qué necesitás |
|---|---|
device | Dispositivo por USB con depuración y MOBILE_UDID (de adb devices). |
emulator | Emulador o simulador encendido y MOBILE_DEVICE_NAME. |
browserstack | BROWSERSTACK_USER, BROWSERSTACK_KEY y BROWSERSTACK_APP. |
Correr la suite
cd herramientas/k0lmena
npm test                                  # web + API
npm run test:web                          # también: test:api · test:mobile · test:all
TAGS=@HU-001 npm test                     # filtrar por tag (bash)
$env:TAGS="@HU-001"; npm test             # filtrar por tag (PowerShell)
npm run report:web                        # también: report:api · report:mobile
Si EVIDENCE está vacía, npm test pregunta al arrancar qué guardar de los tests que pasan: solo captura, o captura + GIF del recorrido.
Evidencias en el reporte
| Suite | Escenario que pasa | Escenario que falla |
|---|---|---|
| Web | Captura final (+ GIF opcional) | Video completo, captura, error con stack, URL y título, logs del navegador (consola, errores JS, requests fallidos, HTTP ≥ 400), logs de Node, trace de Playwright y el DOM de la página al fallar (reports/web/dom/, lo usa el reparador) |
| API | Request y response (el Authorization se oculta) | Lo mismo, más la validación que falló |
| Mobile | Captura final (+ GIF opcional) | Video completo, captura, page source y logs del dispositivo |
Herramientas extra
| Comando | Para qué |
|---|---|
npm run crawler [url] | Genera un archivo de locators recorriendo una página. |
npm run link-tester | Busca enlaces e imágenes rotas en BASEURL. |
npm run explorar | Recorrido exploratorio con navegador: links, imágenes, errores, responsive y tiempos de carga, con capturas, videos e informe HTML (lo usa el explorador-web). |
npm run accesibilidad | Auditoría WCAG 2.2 con axe-core, navegación con teclado y reflow a 320px, con capturas, video e informe HTML (lo usa el analista-accesibilidad). |
npm run rendimiento | Lighthouse en mobile y desktop: Core Web Vitals, oportunidades de mejora y secuencia de carga, con informe HTML (lo usa el auditor-rendimiento-web). |
npm run pixel-perfect | Regresión visual contra la referencia: píxeles y elementos corridos, faltantes, nuevos o con otro estilo, con informe HTML (lo usa el pixel-perfect). |
npm run cross-browser | La suite web o las páginas en Chromium, Firefox y WebKit, con matriz y comparación lado a lado (lo usa el cross-browser). |
npm run reparar | Diagnostica los locators rotos con el DOM guardado al fallar, propone, aplica y verifica (lo usa el reparador-automatizacion). |
npm run correos | Revisa los correos del buzón de prueba Mailpit contra lo esperado, con informe HTML (lo usa el verificador-correos). |
npm run traductor | Cada página en cada idioma: textos sin traducir, cortados y formatos, con informe HTML (lo usa el analista-traductor). |
npm run ux | Usabilidad con las 10 heurísticas de Nielsen en desktop y mobile, con la página 404, capturas e informe HTML (lo usa el evaluador-ux). |
npm run formularios | Validaciones de cada campo sin enviar el formulario, con matriz campo × prueba, capturas e informe HTML (lo usa el probador-formularios). |
npm run permisos | Matriz rol × ruta y rol × endpoint con capturas e informe HTML (lo usa el probador-permisos). |
npm run resiliencia | Fallas simuladas de API, red y recursos desde el navegador, con matriz página × escenario e informe HTML (lo usa el probador-resiliencia). |
npm run monitorear | Monitoreo sintético de solo lectura con historial, informe y aviso a Slack o Teams cuando algo se rompe o se recupera. |
npm run mapa-funcional | Mapa funcional del sitio: páginas, menús, formularios con cada campo, botones y mensajes, sin enviar nada (lo usa el documentador-proyecto, en input/documentacion/). |
npm run record | Graba un flujo con Playwright codegen. |
npm run debug | Corre la suite web en modo debug. |
Pruebas de performance
El performance-mapper arma pruebas de carga, estrés, soak y picos. Nunca usa valores por defecto: la carga y los umbrales los definís vos.
Una prueba de carga genera tráfico real. Corrédla solo contra ambientes de prueba o con autorización de los dueños del sistema.
performance-mapper
- Te guía paso a paso, una pregunta por vez y con una sugerencia justificada en cada una: objetivo y tipo de prueba, herramienta, ambiente (y que no sea producción) y endpoints, usuarios concurrentes, rampa, duración y tiempo de pensamiento (te ayuda a calcularlos desde el volumen de negocio), umbrales y perfiles a correr.
- Deja el plan en
output/performance/<HU>/y te pide confirmación. - Te recomienda la herramienta (la decisión es tuya): k6 para APIs (escala a miles de usuarios) Artillery + Playwright para flujos de navegador (pocos usuarios: cada uno es un Chromium) o JMeter si tu equipo ya lo usa, traés un
.jmxo necesitás otros protocolos. - Escribe el script una vez y lo valida con un smoke.
- Corre con carga solo con tu confirmación explícita para cada corrida.
- Arma el informe de performance: dashboard con veredicto, capacidad observada, métricas y gráficos por corrida, umbrales, p95 por endpoint, hallazgos y recomendaciones.
Comandos
npm run perf                                       # lista los scripts
npm run perf -- <script> smoke                     # valida el script con carga mínima
npm run perf -- <script> load                      # carga objetivo (pide confirmación)
npm run perf -- <script> stress --confirmar        # sin pregunta: CI o con autorización
npm run perf -- <script> load --vus 20 --duracion 2m # k6 y JMeter: pisa la carga| Perfil | Qué hace |
|---|---|
smoke | Carga mínima para validar que el script funciona. |
load | Sube hasta la carga objetivo, la sostiene y baja. |
stress | 1x, 2x y 3x la carga objetivo: busca el punto de quiebre. |
soak | Carga objetivo durante mucho tiempo: fugas de memoria y degradación. |
spike | Salto brusco a un pico y vuelta: cómo se recupera. |
Cada corrida deja en reports/performance/<k6|artillery|jmeter>/ un reporte HTML con el veredicto, requests, req/s, errores, latencias p50/p95/p99, umbrales con el valor medido, detalle por endpoint o paso, códigos de respuesta, checks y, en Artillery, la evolución en el tiempo. Si un umbral no se cumple, el comando termina con error.
Xray, QMetry, AIO Tests, Zephyr, k0lmenaTMT y Azure DevOps
gestor-pruebas y publicador-resultados trabajan con Xray Cloud, Xray Server/Data Center, QMetry para Jira (QTM4J), AIO Tests, Zephyr Scale y k0lmenaTMT, con los mismos comandos para todas.
Se configura en el .env: GESTION_HERRAMIENTA (xray-cloud, xray-dc, qtm4j, aio, zephyr-scale o k0lmena-tmt), GESTION_PROYECTO (la key del proyecto de Jira; en k0lmenaTMT, el id numérico del proyecto) y las credenciales de tu herramienta, explicadas en .env.example.
gestor-pruebas
Crea la carpeta, sube los casos (manuales desde el .xlsx o BDD desde el .feature), los vincula a la historia, crea ciclos y les agrega casos. La primera vez hace una prueba en seco (--dry-run). Guarda la trazabilidad en output/gestion/HU-001-<herramienta>.json: un caso nunca se sube dos veces.
Etiquetas. Cada caso sube con las mismas etiquetas en todas las herramientas, en este orden: la historia (HU-001 y la key de Jira de --historia), el módulo (modulo-registro: el @modulo-x del caso, --modulo, la fila Módulo de la planilla o el nombre de la Feature), la prioridad (critica, alta, media o baja), smoke (los de humo y los críticos), regresion (todos, salvo los de falta-info y bloqueado) y las demás (positivo, CA1…). La planilla y los .feature salen con las mismas. En k0lmenaTMT, volver a subir actualiza las etiquetas de los casos que ya estaban.
Tiempo estimado. Cada caso se sube con su tiempo de ejecución manual: en la descripción y en el campo de tiempo de la herramienta — Original Estimate de Jira en Xray (si el proyecto tiene time tracking), estimatedTime en QTM4J y Zephyr Scale, estimatedEffort en AIO Tests y estimatedDuration en k0lmenaTMT. En Azure DevOps viaja en el JSON de para_azure_devops.py y como etiqueta tiempo-estimado-Xmin. Si la herramienta rechaza el campo, el caso se crea igual con el tiempo en la descripción (GESTION_TIEMPO_NATIVO=0 lo desactiva). Ver la fórmula.
publicador-resultados
Asocia cada escenario a su caso por el tag @CP-XXX y carga el estado, un comentario con el error y las evidencias: captura siempre, GIF si se generó y video solo si falló. Nunca asigna un resultado por aproximación.
Equivalencias
| Concepto | Xray | QTM4J | AIO Tests | Zephyr Scale | k0lmenaTMT |
|---|---|---|---|---|---|
| Caso | Issue Test (Manual o Cucumber) | Test case | Caso (Classic o BDD) | Test case (pasos o script BDD) | Test case (pasos; BDD en la pestaña Gherkin, con automated) |
| Ciclo | Test Execution | Test cycle | Test cycle | Test cycle | Test cycle (cada caso, un cycle suite) |
| Caso ↔ historia | Link "Test" (cobertura) | Requirement link | jiraRequirementIDs | links/issues | La historia como etiqueta |
| Ciclo ↔ historia | Link "Relates" | Requirement link | jiraTaskIDs | links/issues | La historia en la descripción |
Comandos manuales
python scripts/gestion/gestion.py --dry-run carpeta --ruta "HU-001 Registro"
python scripts/gestion/gestion.py subir-casos --origen <casos.xlsx> --carpeta "HU-001 Registro" --historia PROJ-12 --traza HU-001
python scripts/gestion/gestion.py crear-ciclo --nombre "Sprint 5" --historia PROJ-12 --traza HU-001
python scripts/gestion/gestion.py sincronizar-casos --origen <casos.xlsx> --traza HU-001
python scripts/gestion/gestion.py extraer-resultados --reporte <cucumber-report.json | junit.xml>
python scripts/gestion/gestion.py publicar-resultados --ciclo PROJ-60 --resultados <resultados.json> --traza HU-001
Las carpetas van sin barra inicial (en Git Bash, /HU-001 se convierte en una ruta de Windows). Referencia completa en scripts/gestion/README.md.
Casos que cambiaron. Cada caso subido guarda una firma de su contenido. Si después cambia en la planilla o el .feature, subir-casos lo avisa y sincronizar-casos lo pone al día en la herramienta (título, descripción, precondiciones, prioridad, etiquetas, tiempo y pasos o gherkin); los que no cambiaron no se tocan. En QMetry la descripción no se puede cambiar por API, y en k0lmenaTMT los pasos de un caso con ejecuciones tampoco: se actualiza el resto y se avisa.
Resultados de otros frameworks. extraer-resultados también lee JUnit XML (Cypress, Playwright, pytest, Maven, Jest): un .xml o una carpeta con varios. El caso sale del nombre del test (CP-001, cp_001, @HU-001, [PROJ-45]) o de la property test_key, y las evidencias de [[ATTACHMENT|ruta]] (Playwright, Jenkins) y de testrun_evidence (Xray).
k0lmenaTMT
k0lmenaTMT es el gestor de pruebas de la suite k0lmena. Se integra con el token personal (kolm_pat_...) que se genera en k0lmenaTMT: GESTION_HERRAMIENTA=k0lmena-tmt, GESTION_PROYECTO = el id numérico del proyecto (está en su URL) y K0LMENA_TMT_TOKEN (más K0LMENA_TMT_URL si no es http://localhost:4000/api/v1/mcp).
| Tema | Cómo funciona |
|---|---|
| Cargas | Las hace el script, no el agente: con el token, k0lmenaTMT expone su server MCP y scripts/gestion es el cliente. Crea carpetas, casos (pasos, etiquetas, prioridad y tiempo estimado), ciclos y resultados sin pasar cada caso ni cada evidencia por la conversación. Cada escritura es una propuesta (change-set) que el script aplica: todo queda registrado y se puede deshacer desde k0lmenaTMT. |
Conector MCP k0lmena-tmt | Para consultar desde el chat (casos, planes, estadísticas, los tests que más fallan) y ajustes puntuales. |
| Keys | TC-<id> (casos) y CY-<id> (ciclos): se usan igual que las de Xray o Zephyr (--ciclo CY-45, tags @TC-123). |
| Historia | k0lmenaTMT no se conecta a Jira: la historia va como etiqueta del caso y en la descripción del ciclo. |
| Resultados | Estado y tiempo real (la duración del escenario en Cucumber) de cada caso del ciclo, con la captura, el GIF, el video si falló y un resultado.txt con el error como evidencia (la ejecución no tiene campo de comentario). Hasta 10 MB por archivo. Al terminar, el ciclo queda como ejecutado. |
| Solo ciclos del proyecto | k0lmenaTMT no valida que el ciclo sea del proyecto: el script solo escribe en ciclos que creó K0lmenIA o que confirmás con K0LMENA_TMT_CICLOS=CY-12 (por ejemplo, uno creado desde la interfaz). |
| Textos largos | k0lmenaTMT limita a 255 caracteres la descripción, la precondición y el nombre de un paso: el script los acorta y lo que no entra en un paso pasa a sus datos. Los Examples de un Scenario Outline van como un paso más. |
| Comprobado | npm run doctor revisa que k0lmenaTMT responda y que el token valga. Probado contra un k0lmenaTMT real: casos manuales y BDD, ciclo, resultados y evidencias verificadas byte por byte. |
| Ritmo | k0lmenaTMT acepta 20 pedidos por minuto por usuario por defecto y cada escritura son dos: una historia de 30 casos con su ciclo y resultados tarda unos minutos. K0LMENA_TMT_RPM lo ajusta; K0LMENA_TMT_PRIORIDADES mapea las prioridades a sus ids. |
Las mejoras que conviene sumar del lado de k0lmenaTMT (validar el proyecto del ciclo, un límite propio para los tokens, escritura en lote, comentario en la ejecución, consultas de carpetas y ciclos y textos de más de 255 caracteres) están en scripts/gestion/README.md.
Azure DevOps (Test Plans)
Azure DevOps no pasa por gestion.py: se integra por su conector MCP oficial (azure-devops), con ADO_ORGANIZACION, ADO_PAT y ADO_PROYECTO en el .env. Los agentes leen las historias (con comentarios, tareas, padre y vínculos) y la Wiki, y gestor-pruebas crea los Test Cases con sus pasos (los arma scripts/gestion/para_azure_devops.py), los vincula a la historia y los agrega a una suite. Todavía no se publican resultados de ejecución en Azure DevOps.
k0lmena en el pipeline (CI)
Las suites de k0lmena corren solas en el pipeline del equipo, sin agentes ni tokens.
npm run ci -- listar
npm run ci -- generar --plataforma github               # → .github/workflows/k0lmena.yml
npm run ci -- generar --plataforma gitlab --suite all   # → .gitlab-ci.yml (web y api)
npm run ci -- generar --plataforma jenkins              # → Jenkinsfile
npm run ci -- generar --plataforma azure --suite api    # → azure-pipelines.yml
El pipeline instala k0lmena y Chromium, corre las suites, guarda los reportes como artefacto y, si hay GESTION_CICLO, publica los resultados en Xray, QMetry, AIO Tests, Zephyr o k0lmenaTMT (npm run ci -- publicar). No pisa un pipeline que ya existe, salvo con --forzar.
| Plataforma | Dónde va el .env (como secret, nunca en el archivo) |
|---|---|
| GitHub Actions | Secret K0LMENIA_ENV con el contenido del archivo |
| GitLab CI | Variable K0LMENA_ENV_FILE de tipo File, protegida |
| Jenkins | Credencial Secret file con id k0lmenia-env |
| Azure Pipelines | Secure file k0lmenia.env (Pipelines → Library) |
Si una suite falla, el pipeline igual guarda los reportes y publica los resultados, y al final termina en error. Detalle en herramientas/ci/README.md.
Apps con protección anti-bots
Cloudflare, Akamai, DataDome, Imperva, AWS WAF o un captcha pueden frenar al navegador automatizado. K0lmenIA no intenta esquivarlo: lo detecta, lo informa y usa la excepción oficial que da el equipo de la app.
Sin falsos fallos
Si la app responde con un desafío o un acceso denegado, el escenario queda Bloqueado: anti-bots (también al publicarlo en la herramienta de gestión) y el análisis de fallos lo separa de los bugs. Las herramientas avisan al terminar y los agentes frenan y lo reportan.
Header de excepción
Con QA_BYPASS_HEADER y QA_BYPASS_TOKEN, npm test, las herramientas y el navegador de los agentes mandan el header acordado solo a los hosts de la app (QA_BYPASS_HOSTS), nunca a terceros.
Navegador real y ritmo
NAVEGADOR_CANAL=chrome usa el Chrome instalado y RITMO_HUMANO=si agrega pausas entre acciones.
Plan B manual
npm run login abre tu Chrome: resolvés el desafío o el captcha a mano y la sesión queda guardada (SESION=si). Las cookies anti-bots valen para el mismo navegador e IP.
La guía para el equipo de la app explica la excepción por header en Cloudflare, AWS WAF, Akamai, DataDome e Imperva, la lista blanca de IP y las claves de prueba de reCAPTCHA, Turnstile y hCaptcha: herramientas/k0lmena/tools/navegador/README.md. npm run doctor revisa la configuración.
No se disfraza el navegador ni se resuelven captchas automáticamente: esas técnicas fallan de forma intermitente, pueden violar los términos del proveedor y sirven para atacar sitios de terceros. Lighthouse (npm run rendimiento) mide sin el header, porque no puede limitarlo a la app.
Verificación en base de datos
El verificador-datos revisa lo que las pruebas no ven: qué quedó guardado, en qué estado y con qué valores. Soporta PostgreSQL, MySQL / MariaDB, SQL Server y MongoDB, con varias conexiones con nombre.
A pedido
"Verificá si existe el usuario [email protected] y en qué estado quedó." Mira el esquema, arma la consulta con parámetros y te responde.
Dentro de los tests, si lo pedís
Suma steps de base de datos a los .feature de web, API o mobile solo cuando se lo pedís; después corren con npm test, sin tokens.
Seguro por defecto
Solo lectura, en transacciones que se descartan; datos sensibles enmascarados. Escribir requiere habilitarlo y confirmar cada operación.
Configuración
DB_CONEXIONES=principal,pagos              # la primera es la de por defecto
DB_PRINCIPAL_MOTOR=postgres                # postgres | mysql | mariadb | sqlserver | mongodb
DB_PRINCIPAL_HOST=localhost
DB_PRINCIPAL_PUERTO=5432
DB_PRINCIPAL_BASE=tienda
DB_PRINCIPAL_USUARIO=qa_lectura
DB_PRINCIPAL_CLAVE=...
DB_PRINCIPAL_ESCRITURA=no                  # si = permite escribir con confirmación
DB_PRINCIPAL_PRODUCCION=no                 # si = nunca escribe
Steps para los tests
Solo cuando lo pedís. Los mappers (web, API y mobile) no agregan verificaciones de base de datos por su cuenta: si un caso menciona datos guardados, lo dejan como sugerencia en el reporte de mapeo. El verificador-datos, ante una consulta puntual, responde sin tocar los .feature.
When envío un POST a "/usuarios" con el body: ...
And guardo el campo "id" de la respuesta como "idUsuario"
Then existe en la base de datos un registro en "usuarios" donde "id" es "{idUsuario}"
And el registro de "usuarios" donde "id" es "{idUsuario}" tiene:
  | campo  | valor  |
  | estado | ACTIVO |
  | baja   | (nulo) |
And la base de datos "pagos" tiene 1 registro en "movimientos" donde:
  | campo      | valor       |
  | usuario_id | {idUsuario} |
También: no existe en la base de datos …, consulto en la base de datos: (SQL, o JSON en MongoDB), la consulta devuelve N filas, el campo "x" de la consulta es "y" y guardo el campo "x" de la consulta como "var". Si el dato se guarda de forma asíncrona, los steps reintentan hasta DB_ESPERA_MS. Cada verificación deja en el reporte la consulta y las filas encontradas.
Sin agente
cd herramientas/k0lmena
npm run bd -- conexiones                                   # lista y prueba las conexiones
npm run bd -- esquema --tabla usuarios                     # columnas de una tabla
npm run bd -- existe --tabla usuarios --donde [email protected]
npm run bd -- consultar --sql "SELECT id, estado FROM usuarios WHERE email = ?" --param [email protected]Para preparar o limpiar datos, la conexión necesita DB_<NOMBRE>_ESCRITURA=si y el agente muestra la sentencia y pide confirmación antes de cada operación. Con DB_<NOMBRE>_PRODUCCION=si nunca escribe. Recomendado: un usuario de base de datos con permisos de solo lectura.
Pruebas exploratorias
El explorador-web recorre tu sitio (el APP_URL del .env o la URL que le digas) y busca lo que se rompe sin que nadie lo note. Primero un recorrido automático con un script, sin gastar tokens por página; después explora a mano con Playwright MCP lo que necesita criterio.
| Qué revisa | Cómo |
|---|---|
| Links e imágenes | Links rotos internos y externos (aparte, los que no se pueden verificar porque el sitio bloquea robots), imágenes que no cargan e imágenes sin alt. |
| Errores | Errores de JavaScript, errores de consola y recursos que fallan (scripts, CSS, fetch con 4xx/5xx o sin respuesta). |
| Responsive | En 360x740, 390x844, 768x1024, 1366x768 y 1920x1080: scroll horizontal y qué elemento se sale, texto de menos de 12px, objetivos táctiles chicos y muy juntos (WCAG 2.5.8) y falta de meta viewport. |
| Rendimiento | Tiempo de carga, primer byte, DOM listo, requests y peso de cada página; las lentas son hallazgos. |
| Exploración manual | Menús (también el mobile), formularios sin enviar, búsquedas, la página 404, recargar a mitad de un flujo. Con misión y tiempo acotado. |
explorador-web usa tokens
- Recorre el sitio con
npm run explorar: captura cada página y cada resolución con los problemas marcados en rojo y graba un video del recorrido y de cada resolución. - Revisa los hallazgos: reintenta los dudosos, mira las capturas y ajusta la severidad con su motivo.
- Explora a mano con Playwright MCP lo que un recorrido automático no ve.
- Arma el informe HTML: indicadores, gráficos, cada hallazgo con su captura (clic para ampliar), tiempos de carga, matriz de responsive, videos, links rotos, detalle por página y recomendaciones.
npm run explorar -- --url https://staging.mi-app.com --max-paginas 50 # sin agentes ni tokens
npm run explorar -- --resoluciones 360x740,768x1024,1366x768 --video noSolo navega con GET: no envía formularios y no abre ni verifica links de cierre de sesión o borrado. Todo queda en output/exploratorias/<HU o sitio>/ y la corrida anterior pasa a historial/ (se guardan las últimas 5) y el informe la compara.
Accesibilidad
El analista-accesibilidad audita tu sitio contra WCAG 2.2 (nivel AA por defecto): primero una auditoría automática, sin gastar tokens por página, y después una revisión manual de lo que una herramienta no puede juzgar.
| Qué revisa | Cómo |
|---|---|
| Reglas WCAG | axe-core en cada página, con los textos en español: contraste, textos alternativos, etiquetas de formularios, nombres de botones y links, idioma, estructura, ARIA. También las buenas prácticas. |
| Teclado | Recorre la página con Tab: elementos que reciben foco sin indicador visible (2.4.7), trampas de foco (2.1.2) y enlace para saltar al contenido (2.4.1). Muestra el orden del foco. |
| Reflow | A 320px de ancho no tiene que haber scroll horizontal (1.4.10, equivale a un zoom del 400 %). |
| Revisión manual | Con el snapshot de accesibilidad de Playwright (lo que "oye" un lector de pantalla): si los textos alternativos describen, encabezados y regiones, formularios y mensajes de error, menús y modales con teclado, zoom, color y movimiento. |
analista-accesibilidad usa tokens
- Audita con
npm run accesibilidad: captura cada página con los elementos que fallan marcados en rojo, cada elemento por separado y un video del recorrido. - Revisa los hallazgos: confirma con las capturas, ajusta la severidad y decide lo que axe no pudo.
- Revisa a mano con Playwright MCP los flujos más importantes.
- Arma el informe HTML: cumplimiento, criterios WCAG incumplidos con su nombre y nivel, cada problema con sus elementos, capturas y cómo corregirlo, teclado y orden del foco, y recomendaciones.
npm run accesibilidad -- --url https://staging.mi-app.com --nivel AA # sin agentes ni tokens
npm run accesibilidad -- --paginas https://mi-app.com/registro,https://mi-app.com/login --historia HU-001Una auditoría automática detecta entre un 30 y un 50 % de los problemas de accesibilidad: el agente nunca dice que el sitio "cumple", dice qué no cumple y qué faltó revisar. Todo queda en output/accesibilidad/<HU o sitio>/ y la corrida anterior pasa a historial/ (se guardan las últimas 5) y el informe la compara.
Rendimiento web
El auditor-rendimiento-web mide qué tan rápido carga cada página para una persona y por qué, con Lighthouse en mobile y desktop. No es una prueba de carga con muchos usuarios: eso es el performance-mapper.
auditor-rendimiento-web usa tokens
- Mide cada página con
npm run rendimiento: puntajes, Core Web Vitals (LCP, CLS y TBT) con los umbrales de Google, FCP y Speed Index. - Encuentra las oportunidades de mejora con el ahorro estimado y los recursos que las causan, el elemento LCP, el peso por tipo de recurso y el código de terceros.
- Arma el informe HTML con la secuencia de carga en capturas, el reporte nativo de Lighthouse de cada página y las recomendaciones priorizadas.
npm run rendimiento -- --url https://staging.mi-app.com --max-paginas 5 # sin agentes ni tokens
npm run rendimiento -- --paginas https://mi-app.com/,https://mi-app.com/login --repeticiones 3Son datos de laboratorio (una carga simulada en condiciones fijas): sirven para encontrar y comparar problemas, no para afirmar cómo lo vive cada persona. Para comparar antes y después, usá --repeticiones 3. Necesita Node 22.19 o superior.
Análisis de fallos
Cuando npm test falla, el analista-fallos separa los bugs reales de los tests rotos, inestables, de datos o de ambiente, para no revisar falla por falla.
analista-fallos usa tokens
- Clasifica cada falla con
scripts/analizar_fallos.py: posible bug, locator o espera, ambiente, datos de prueba, error en la automatización o paso sin definir, y rescata captura, video y trace. - Reintenta los fallidos (con tu ok) y suma el reintento: lo que falló y después pasó queda como inestable.
- Confirma la causa con la evidencia, redacta los reportes de bug de los reales y propone cómo arreglar el resto.
python scripts/analizar_fallos.py                       # la última corrida de npm test
python scripts/analizar_fallos.py --agregar-reintento # después de volver a correr los fallidosVolver a correr los fallidos corre la suite contra el ambiente: se hace solo con tu confirmación. Los cambios en la automatización los hacen los mappers.
Logs del servidor
El analista-logs lee los logs de la aplicación y los cruza con la corrida de npm test: qué errores hubo, cuándo, y qué error del servidor había detrás de cada escenario que falló.
analista-logs usa tokens
Entiende logs de la app (ISO, YYYY/MM/DD), accesos de nginx y Apache, JSON por línea, syslog y .gz. Agrupa los errores por firma (ignorando números e ids), les pega su stack trace y los ubica en el tiempo. Los steps de k0lmena guardan el inicio y el fin de cada escenario, así cada falla queda con los errores del servidor mientras corría. Entrega informe-logs.html con errores y advertencias por minuto, las firmas y cada escenario fallido con su contexto.
python scripts/analizar_logs.py --logs "input/logs/*.log" --corrida web
python scripts/analizar_logs.py --logs input/logs/app.log --desde 2026-10-11T10:00 --hasta 2026-10-11T11:00Sin --desde ni --hasta analiza la ventana de la corrida más 5 minutos antes y después. input/logs/ no se versiona. Bajar logs de un servidor compartido se confirma antes. Salida en output/logs/<nombre>/.
Cobertura y trazabilidad
El analista-cobertura responde “¿qué nos falta probar?”: cruza criterios, casos, automatización, gestión, resultados y bugs de cada historia y marca dónde se corta la cadena.
analista-cobertura usa tokens
- Cruza con
scripts/analizar_cobertura.pylos criterios (historia, ficha de contexto, tablas de cobertura o Jira), los casos manuales y BDD, la automatización de k0lmena, la trazabilidad con Xray/QMetry/AIO, los últimos resultados y los bugs. - Marca los huecos: criterios sin casos, casos sin criterio, sin automatizar, bloqueados o sin ejecutar, fallidos, sin subir a la herramienta de gestión y falta información abierta.
- Arma el informe HTML con el embudo de la historia al resultado, la cobertura por criterio, la matriz caso por caso y qué hacer con cada hueco.
python scripts/analizar_cobertura.py --historia HU-001
python scripts/analizar_cobertura.py # todas las historias del repoSolo lee: no crea casos ni automatiza. El par @HU + @CP es lo que traza cada caso; un escenario sin @CP aparece como hueco.
Regresión visual (pixel perfect)
El pixel-perfect detecta qué cambió visualmente entre la versión aceptada de tu sitio (la referencia) y la actual: qué se corrió y cuántos píxeles, qué cambió de tamaño, de texto o de color, qué falta y qué apareció.
| Qué compara | Cómo |
|---|---|
| Píxeles | Porcentaje de la pantalla que cambió y las regiones con cambios, con el mapa de diferencias en rojo. |
| Elementos | La posición y el tamaño de cada título, link, botón, campo e imagen: corridos (con los px), faltantes, nuevos y con otro texto. |
| Bloques desplazados | Si muchos elementos se movieron igual, es una sola causa (un banner nuevo empujó todo): informa el bloque y la causa probable. |
| Estilos | Color de fondo, color del texto, tamaño y grosor de la letra. |
pixel-perfect usa tokens
- La primera corrida crea la referencia: una captura estable de cada página en cada resolución (sin animaciones, con fuentes e imágenes cargadas y las zonas dinámicas ocultas).
- Las siguientes comparan contra ella, píxel a píxel y elemento por elemento.
- Separa lo intencional (lo que pidió la historia) de las regresiones.
- Arma el informe: comparador deslizable referencia/actual, mapa de diferencias, regiones de cerca y el antes y después de cada hallazgo.
npm run pixel-perfect -- --url https://staging.tu-app.com --resoluciones 390x844,1366x768 # sin agentes ni tokens
npm run pixel-perfect -- --ocultar ".banner,.fecha"     # zonas que cambian solas
npm run pixel-perfect -- --aceptar todas # lo actual pasa a ser la referencia (con tu ok)La referencia también puede ser un diseño de Figma exportado como PNG. Todo queda en output/pixel-perfect/<HU o sitio>/: la referencia/ se conserva y, en cada comparación, la corrida anterior pasa a historial/ (se guardan las últimas 5) y el informe la compara.
Cross-browser
El cross-browser encuentra lo que funciona o se ve distinto según el navegador: Chromium (Chrome y Edge), Firefox y WebKit (el motor de Safari), en desktop y mobile.
Modo suite
Corre la suite web de k0lmena una vez por navegador (cada uno en su carpeta) y arma la matriz escenario × navegador: pasa en todos, falla solo en algunos o falla en todos.
Modo páginas
Sin automatización: recorre las páginas en cada navegador y las compara contra el base: errores de JavaScript y de consola solo en uno, desborde, elementos que faltan o se corren y estilos distintos.
cross-browser usa tokens
El informe trae la matriz con la captura de cada navegador, las páginas lado a lado con el comparador deslizable, y cada diferencia con su error y causa probable. Lo que falla en todos no es un tema de navegador: lo deriva al analista-fallos.
npm run cross-browser -- --historia HU-003                              # modo suite (corre contra el ambiente: con tu ok)
npm run cross-browser -- --modo paginas --url https://staging.tu-app.com # solo GET
cd herramientas/k0lmena && npx playwright install firefox webkit # si faltan los navegadoresWebKit es el motor de Safari y encuentra casi todo, pero no reemplaza un Safari real de Mac o iPhone. Salida en output/cross-browser/<HU, sitio o suite>/; la corrida anterior pasa a historial/ (se guardan las últimas 5) y el informe la compara.
Reparación de la automatización
Cuando un test falla porque la pantalla cambió (un botón con otro nombre, un selector que ahora encuentra varios elementos), el reparador-automatizacion propone el locator nuevo, lo aplica y verifica que el test vuelva a pasar. Si falla porque la aplicación tiene un bug, no toca el test.
| Diagnóstico | Qué hace |
|---|---|
| Ya no existe | Busca el elemento más parecido (rol, nombre, texto, label, placeholder, data-testid) y propone el locator más robusto que encuentre un solo elemento. En un paso de verificación (Then) lo marca como posible bug. |
| Coincide con varios | Prueba con exact: true o lo acota al contenedor de cada elemento (la tarjeta del producto) y te deja elegir. |
| Existe pero no se ve | Falta un paso previo (abrir un menú) o la app no lo muestra. |
| Existe y se ve | El locator está bien: propone la espera adecuada. |
reparador-automatizacion usa tokens
- Analiza las fallas del último
npm test(o del analista-fallos) contra el DOM que k0lmena guardó al fallar, sin tocar archivos. - Aplica las reparaciones seguras (o las que confirmes), con copia de respaldo y
cambios.diff. - Verifica corriendo solo los escenarios reparados (con tu ok) y arma el informe con el diagnóstico, el cambio y las capturas.
npm run reparar -- --historia HU-001                    # diagnóstico y propuestas
npm run reparar -- --aplicar seguras --historia HU-001  # o --aplicar R-01,R-03
npm run reparar -- --verificar --historia HU-001 # vuelve a correr los reparadosDesde esta versión, k0lmena guarda el DOM de la página al fallar (reports/web/dom/) y se corrigió el viewport: si VIEWPORT_WIDTH y VIEWPORT_HEIGHT quedan vacíos, la ventana usa 1366x768 (antes quedaba en 0 y los clics fallaban). Salida en output/reparaciones/<HU o suite>/.
Selección de casos para un cambio
El selector-casos-de-prueba responde “¿qué pruebo con este cambio?” sin correr toda la regresión: cruza lo que cambió con todos los casos y entrega una lista priorizada, explicada y lista para ejecutar.
| Entrada | Qué usa |
|---|---|
| El cambio | Un rango de git (archivos, commits con sus keys de Jira y funciones tocadas), los archivos de un PR, historias o issues de Jira y Azure DevOps, o las notas de la release. |
| El inventario | Casos manuales (Excel), BDD y automatizados en k0lmena, con su último resultado, los inestables y los bugs abiertos. |
| El resultado | Imprescindibles, recomendados y regresión mínima (smoke y prioridad Crítica), con el porqué, el tiempo estimado, el ahorro y los cambios que ningún caso cubre. |
selector-casos-de-prueba usa tokens
Entrega informe-seleccion.html con los comandos listos para copiar (bash y PowerShell) para lo automatizado y seleccion.csv con lo manual. No corre las pruebas: lo automatizado va con npm test, sin tokens.
python scripts/seleccionar_casos.py --nombre release-2.4 --git main..feature/pagos --repo ../mi-app
python scripts/seleccionar_casos.py --nombre pr-42 --historias HU-003 --presupuesto-min 60
TAGS="(@HU-003 and (@CP-001 or @CP-003))" npm test -- web # el comando que arma el informeOpcional: input/mapa-componentes.json relaciona carpetas del código con historias para afinar la selección. Salida en output/seleccion-casos/<nombre>/.
Revisión de casos y tiempo estimado
El revisor-casos revisa casos que ya existen (manuales en Excel o escenarios BDD) antes de ejecutarlos, subirlos o automatizarlos, y calcula cuánto lleva ejecutarlos a mano.
revisor-casos usa tokens
Un script revisa cada caso (título, precondiciones, pasos accionables, resultado esperado verificable, datos, prioridad, trazabilidad) y le da un puntaje de 0 a 100; detecta duplicados y casi duplicados y las historias sin casos negativos o de borde. El agente suma lo que pide criterio y propone la versión mejorada de los peores. Entrega informe-revision.html; si lo pedís, la planilla corregida va en un archivo nuevo, nunca pisa la original.
python scripts/revisar_casos.py --historia HU-001
python scripts/revisar_casos.py --origen output/casos-de-prueba/manuales/casos-HU-001.xlsx,output/casos-de-prueba/bdd/HU-001-registro.feature
python scripts/estimacion.py output/casos-de-prueba/manuales/casos-HU-001.xlsx   # solo el tiempo
Cómo se calcula el tiempo estimado
Cada caso (manual o BDD) lleva el tiempo que tarda una persona que conoce la aplicación en ejecutarlo de punta a punta. Lo calcula scripts/estimacion.py y aparece en la planilla (columna Tiempo estimado (min) con el total), en el .md, en la herramienta de gestión, en la selección de casos y en esta revisión.
tiempo del caso = (preparación + Σ pasos + registro) × factor   # hacia arriba a 0,5 min, mínimo 1
tiempo del paso = acción + datos + verificación| Parte | Cómo se calcula |
|---|---|
| Acción | Según el verbo: navegar 0,5 · clic 0,25 · completar 0,3 por campo · iniciar sesión 1 · subir o bajar un archivo 1 · esperar un correo o un proceso 2 · consultar una base, una API o logs 2 · leer 0,5 · otra 0,5 min. |
| Datos | 0,15 min por cada dato extra del paso. |
| Verificación | 0,5 min si hay resultado esperado (o es un Then) + 0,25 por cada verificación extra (hasta 4). |
| Preparación | 1 min + 0,5 por precondición (hasta 3) + 2 si hay que crear datos o usuarios. |
| Registro | 0,5 min + 0,1 por paso (marcar el resultado y guardar la evidencia). |
| Factor | 1,1 para casos negativos o de borde; ESTIMACION_FACTOR del .env multiplica todo (por ejemplo 1,3 para alguien que recién conoce la aplicación). |
Si la planilla ya trae un valor en Tiempo estimado (min), ese manda: se respeta lo que cargó la persona. Fórmula completa, con ejemplos, en plantillas/estimacion-tiempos.md. Salida de la revisión en output/revision-casos/<HU o nombre>/.
Charters y sesiones exploratorias
El generador-charters planifica pruebas exploratorias por sesiones (session-based testing): cada charter dice qué explorar, con qué foco y heurísticas, con qué datos y en cuánto tiempo. Después arma el informe con lo que encontró cada sesión.
generador-charters usa tokens
Entrega las hojas de sesión (charters.html y .md) y una plantilla de notas por sesión en sesiones/CH-XX.md. Quien explora anota con prefijos (BUG: PREGUNTA: IDEA: RIESGO: CUBIERTO: SIN CUBRIR: NOTA: y Tiempo:) y el informe sale de esas notas: bugs, preguntas, riesgos, reparto del tiempo y áreas cubiertas.
python scripts/generar_charters.py --nombre HU-003             # hojas de sesión
python scripts/generar_charters.py --nombre HU-003 --informe # informe-sesiones.html desde sesiones/Si le pedís que explore él, usa Playwright MCP y completa las notas de la sesión. Salida en output/charters/<HU o nombre>/.
Correos
El verificador-correos comprueba que los mails que manda tu aplicación (registro, confirmación, recuperar contraseña, pedidos, notificaciones) lleguen bien: a la persona correcta, con el contenido correcto y viéndose bien en los clientes de correo. Usa Mailpit, un buzón de prueba que atrapa los mails del ambiente de pruebas sin entregarlos a nadie.
| Qué revisa | Cómo |
|---|---|
| Lo esperado | Por cada caso: destinatario, remitente, asunto, textos que tiene (y que no), links y adjuntos. Marca los que no llegaron. |
| Contenido | Variables sin reemplazar ({{nombre}}, undefined, null), asunto, versión de texto plano y tamaño (Gmail recorta desde 102 KB). |
| Links e imágenes | Links rotos, a localhost o sin https; imágenes sin texto alternativo o que apuntan a rutas locales. |
| Cómo se ve | Compatibilidad del HTML con Outlook, Gmail, Apple Mail y otros (revisión de Mailpit) y captura en desktop (700 px) y mobile (375 px). |
verificador-correos usa tokens
- Levantá Mailpit y configurá el SMTP de la app de pruebas a
localhost:1025. - Disparás el envío (vos,
npm testo el agente con tu ok: crea datos). - Revisa el buzón contra lo esperado de cada caso y arma el informe con la vista de cada correo.
- Si lo pedís, suma steps de correo a los
.featurede k0lmena, que corren sin tokens.
docker compose -f herramientas/mailpit/docker-compose.yml up -d      # web y API en :8025, SMTP en :1025
npm run correos -- --para [email protected] --espera input/correos/espera-HU-001.json
npm run correos -- --para [email protected] --esperar 1 --timeout-s 90   # espera a que llegue
Then llega un correo a "[email protected]" con el asunto "Confirmá tu cuenta"
And el correo contiene "Hola Ana"
And el correo no contiene "undefined"
When guardo el link del correo que contiene "/confirmar" como "linkConfirmacion"Solo buzones de prueba: nunca casillas reales ni el servidor de correo de producción. Vaciar el buzón (--limpiar-buzon) se confirma. Salida en output/correos/<HU o buzón>/; la corrida anterior pasa a historial/ (se guardan las últimas 5) y el informe la compara.
Traducciones e idiomas
El analista-traductor recorre cada página en cada idioma (el primero es la referencia) y encuentra lo que falta traducir o se ve mal en otro idioma. Propone la traducción de lo que falta.
| Qué busca | Ejemplo |
|---|---|
| Textos sin traducir | Un párrafo en español en la versión en inglés, o igual al de la referencia; también en placeholders, textos alternativos y aria-label. |
| Claves a la vista | checkout.add_to_cart, MISSING_TRANSLATION. |
| Caracteres rotos | EnvÃo en lugar de Envío. |
| Textos cortados | Un botón que no deja lugar para la traducción, más larga. |
| Formatos | 1.234,56 en la versión en inglés; “octubre” en una fecha en inglés; el atributo lang equivocado. |
analista-traductor usa tokens
Cambia de idioma con los hreflang del sitio, con --url-idioma (por ejemplo https://tu-app.com/{idioma_corto}/) o pidiendo el idioma al navegador. El informe trae el porcentaje traducido por idioma, cada página en todos los idiomas lado a lado y cada problema con su recorte.
npm run traductor -- --url https://staging.tu-app.com --idiomas es-AR,en-US,pt-BR # sin agentes ni tokens
npm run traductor -- --url https://tu-app.com --url-idioma "https://tu-app.com/{idioma_corto}/"La detección de idioma es una heurística: el agente confirma cada caso y descarta nombres propios y marcas. Salida en output/traductor/<HU o sitio>/; la corrida anterior pasa a historial/ (se guardan las últimas 5) y el informe la compara.
Usabilidad
El evaluador-ux revisa qué confunde, frena o hace equivocar a la persona, con las 10 heurísticas de Nielsen: un recorrido automático por las páginas y uno manual por los flujos importantes.
evaluador-ux usa tokens
El recorrido automático revisa, en desktop y mobile, lo que se puede medir: la página 404 (si ayuda a volver), menús muy largos o sin la sección actual marcada, nombres distintos para la misma acción, links que abren otra pestaña sin avisar, botones solo con ícono, campos con el placeholder como única etiqueta, mensajes técnicos a la vista, la acción principal abajo del pliegue en mobile y más. El agente recorre los flujos con Playwright MCP y suma lo que solo se ve usándolos. Entrega informe-ux.html con el puntaje por heurística, cada hallazgo con su captura y recomendaciones.
npm run ux -- --url https://staging.tu-app.com   # sin agentes ni tokens
npm run ux -- --url https://tu-app.com/checkout --max-paginas 4 --resoluciones 1440x900,390x844No avanza en un flujo que crea datos (un pedido, una cuenta) sin confirmación. Salida en output/ux/<HU o sitio>/; la corrida anterior pasa a historial/ y el informe la compara.
Formularios
El probador-formularios prueba las validaciones de cada campo de un formulario sin enviarlo: obligatorios, largos, formatos, límites y mensajes de error.
probador-formularios usa tokens
Encuentra los formularios, deduce qué es cada campo (tipo, etiqueta, required, maxlength, min/max, pattern) y le prueba lo que corresponde: vacío, solo espacios, más largo que el máximo, emails y teléfonos inválidos, números fuera de rango, nombres con acentos y ñ. Marca los valores inválidos aceptados y los válidos rechazados, campos sin etiqueta y mensajes que no dicen qué corregir. Si la historia define reglas, el agente las compara. Entrega informe-formularios.html con la matriz campo × prueba y capturas con los errores a la vista.
npm run formularios -- --url https://staging.tu-app.com/registro   # sin agentes ni tokens
npm run formularios -- --url https://staging.tu-app.com/registro --enviar-vacio # solo con confirmaciónNunca envía un formulario con datos: bloquea los envíos que no son GET. Lo único que puede enviar, con confirmación, es el formulario vacío (--enviar-vacio). Salida en output/formularios/<HU o sitio>/.
Permisos por rol
El probador-permisos verifica que cada rol vea y pueda hacer solo lo que le corresponde.
probador-permisos usa tokens
Inicia sesión con cada rol del .env (PERMISOS_ROLES, PERMISOS_<ROL>_USUARIO/_CLAVE/_TOKEN) más el anónimo, recorre el sitio, abre cada ruta con cada rol por URL directa y pide los endpoints con la sesión y el token de cada uno. Arma la matriz rol × ruta y rol × endpoint (abre, niega, pide login), qué menús y botones ve cada rol y las diferencias con la regla esperada (estados-y-permisos.md del documentador o la historia). Hallazgos típicos: rutas protegidas abiertas sin login, URLs de otro rol, botones visibles que después niegan el acceso y APIs sin autenticación.
npm run permisos -- --url https://staging.tu-app.com --endpoints "GET /api/usuarios"Solo GET: no hace clics con efecto ni envía formularios sin confirmación. No guarda credenciales. Salida en output/permisos/<HU o sitio>/.
Resiliencia
El probador-resiliencia responde qué ve la persona cuando algo falla abajo.
probador-resiliencia usa tokens
Desde el navegador intercepta la red y simula, página por página: API con 500, 503 o 404, timeout, red lenta, sin conexión, respuestas vacías, JSON roto o campos en null, y estáticos (CSS, JS, imágenes, fuentes) que no cargan. Detecta pantallas en blanco, fallas silenciosas, spinners infinitos, mensajes técnicos, errores de JavaScript, reintentos y si la página se recupera cuando vuelve la red. Entrega la matriz página × escenario con captura de cada uno.
npm run resiliencia -- --url https://staging.tu-app.com/productos --escenarios api-500,timeout,offlineNo genera carga ni ataca el servidor: solo intercepta lo que pide el navegador. Salida en output/resiliencia/<HU o sitio>/.
Triage de bugs y consultas
triador-bugs usa tokens
Antes de cargar un bug busca candidatos en Jira (JQL), Azure DevOps (WIQL), los bugs locales y los issues del repositorio, incluidos los cerrados, y con scripts/buscar_duplicados.py los clasifica en duplicado, posible regresión, relacionado o distinto. Sugiere severidad y prioridad con su criterio, componente, responsable (por CODEOWNERS y commits) e historia a vincular. Crear, vincular o comentar en la herramienta, solo con tu confirmación. Salida en output/triage/.
consultor-proyecto usa tokens
Responde preguntas del producto solo con la documentación del proyecto (input/documentacion/, fichas de contexto y artefactos), citando la fuente original de cada dato y separando lo que dice la historia de lo que hace hoy el código. Si no está documentado lo dice y propone el FI-XX.
Analytics y píxeles
El analista-analytics responde si la web mide lo que tiene que medir, y solo eso, con lo que sale por la red.
analista-analytics usa tokens
Captura con Playwright los hits de GA4, GTM, Google Ads, Floodlight, Meta, LinkedIn, TikTok, Microsoft Ads, Pinterest, X, Adobe, Segment, Mixpanel, Amplitude, Matomo, Hotjar y Clarity, antes y después del banner de cookies (aceptando o rechazando) y con acciones que disparan eventos. Compara contra el plan de medición (input/analytics/), detecta PII en claro, píxeles sin consentimiento, duplicados, errores de envío y varias cuentas, lee el dataLayer y el consent mode, y confirma por API que el dato llegó (GA4 y Matomo, solo lectura).
npm run analytics -- --url https://qa.tu-sitio.com --plan input/analytics/plan-medicion.json --consentimiento aceptarLas acciones con efecto (enviar un formulario real, pagar) y las credenciales del proveedor se confirman. Salida en output/analytics/<HU o sitio>/.
Chatbots
El probador-chatbot prueba conversaciones completas, repetidas, porque un bot no responde siempre igual.
probador-chatbot usa tokens
Corre guiones multi-turno (input/chatbots/) contra la API del bot (cualquier endpoint, o Direct Line para Bot Framework, Azure Bot, Copilot Studio y Teams) y mide éxito y consistencia entre repeticiones, intents, contexto, fallback, derivación y latencia p50/p95. Prueba también el widget web, WhatsApp o Teams en el canal de prueba, y si el bot usa un LLM suma lo del probador-ia.
npm run chatbot -- input/chatbots/mi-bot.json --repeticiones 3Los secretos van en el .env y en el guion como ${VARIABLE}. Salida en output/chatbots/<HU o bot>/.
Estrategia de pruebas del proyecto
Cómo probar un proyecto entero, decidido con sus datos reales y sus particularidades.
estratega-proyecto usa tokens
Claude te entrevista (producto, equipo y proceso, técnica, fuentes) con el skill estrategia-proyecto, y el agente mide el proceso real en Jira o Azure DevOps: cumplimiento de los sprints, historias que vuelven de QA, entregas tarde, QA apretado al final del sprint y bugs que llegan a producción. Recomienda, con la evidencia de cada decisión, si testear en el sprint o a sprint vencido, si automatizar y qué primero, la pirámide de pruebas, los tipos de prueba con el agente que los cubre, riesgos, métricas y una hoja de ruta. Salida en output/estrategias/.
Métricas de QA
"¿Cuánto testeamos este mes?" con números de las fuentes reales y un dashboard para explorarlos.
analista-metricas usa tokens
Junta datos de Jira, Xray, Zephyr, QMetry, AIO, Azure DevOps, TestRail, k0lmenaTMT, cualquier MCP conectado, exportes CSV o Excel (input/metricas/) y lo que dejó K0lmenIA, y responde con ejecuciones y resultados, casos ejecutados, manual y automatizado, bugs por criticidad y módulo, días de resolución, escapados a producción, cumplimiento de sprints e historias devueltas. El dashboard se abre sin internet, con filtros en vivo y clic en una barra para filtrar.
npm run metricas-qa -- importar input/metricas/jira-bugs.csv --datos output/metricas/mi-proyecto/datos.json
npm run metricas-qa -- consultar --datos output/metricas/mi-proyecto/datos.json --desde 2026-10-01 --hasta 2026-10-31
Causa raíz de bugs en el código
analista-causa-raiz usa tokens
Con acceso al código (repo local o GitHub, GitLab, Azure Repos y Bitbucket), sigue el recorrido desde la entrada hasta la falla, junta la evidencia y descarta las otras hipótesis. Propone el fix como diff con su riesgo, busca el mismo error en otros lugares y sugiere las pruebas de regresión. Solo lectura: no crea ramas, commits ni PR. Salida en output/causa-raiz/.
Virtualización de servicios
El virtualizador-servicios destraba a QA cuando una dependencia no existe, se cae o no deja forzar errores.
virtualizador-servicios usa tokens
Levanta un servidor de mocks con mappings en el formato de WireMock (sirven también en un WireMock real): stubs desde el contrato OpenAPI, grabados de la API real o a mano, escenarios con estado, demoras, respuestas rotas y cortes de conexión. Prueba la app contra el mock y verifica en el journal qué llamó y cuántas veces.
npm run virtualizar -- desde-openapi input/api/pagos.yaml --mappings input/virtualizacion/pagos
npm run virtualizar -- servir --mappings input/virtualizacion/pagos --puerto 8089Grabar contra la API real cuando cambia datos se confirma. Los mappings quedan en input/virtualizacion/ y el informe en output/virtualizacion/<servicio>/.
Fuzzing de APIs
El probador-api-fuzzing genera cientos de requests desde el contrato para encontrar lo que nadie pensó en probar.
probador-api-fuzzing usa tokens
Con Schemathesis, a partir del OpenAPI o del GraphQL, busca errores 500, respuestas fuera de contrato, códigos no documentados, validaciones flojas y fallas de autenticación. Agrupa las fallas por endpoint y chequeo, las clasifica por severidad, descarta el ruido y deja el curl para reproducir cada una, sin el token.
npm run fuzzing -- --contrato input/api/pagos.yaml --max-ejemplos 50 --semilla 1Por defecto solo métodos seguros (GET, HEAD, OPTIONS); --incluir-escritura se confirma. Requiere pip install schemathesis. Salida en output/fuzzing/<api>/.
¿QA está listo para probar?
El verificador-ambiente evita perder el día probando sobre un ambiente roto o con la versión equivocada.
verificador-ambiente usa tokens
Revisa en solo lectura los servicios y sus healthchecks, la versión desplegada contra la release (versión o commits / PR), el smoke de las pantallas clave, el vencimiento de los certificados, el DNS, los feature flags, las dependencias externas y las métricas. Responde Listo, Listo con observaciones o No listo, con lo que bloquea y a quién derivarlo.
npm run ambiente -- input/ambientes/qa.jsonLa configuración va en input/ambientes/ (ver qa.ejemplo.json); los tokens, como ${VARIABLE} del .env. Salida en output/ambientes/<ambiente>/.
Errores de producción
El analista-produccion cierra el ciclo producción → QA: lo que se rompió en manos de las personas usuarias vuelve como bugs priorizados y casos de regresión que faltaban.
analista-produccion usa tokens
Lee en solo lectura los issues de Sentry, Datadog, New Relic o un exporte de Crashlytics, los compara antes y después del release (nuevos, regresiones, en aumento), los prioriza por personas afectadas y eventos, los cruza con los bugs que ya existen y propone los que faltan, y marca los flujos sin un caso de regresión que los hubiera atrapado.
npm run produccion -- traer sentry --carpeta output/produccion/2.4.0
npm run produccion -- analizar --carpeta output/produccion/2.4.0 --release 2.4.0 --corte 2026-10-24Solo lectura: nunca resuelve, asigna ni silencia un issue. Las credenciales van en el .env. Salida en output/produccion/<release>/.
Feedback de usuarios
El analista-feedback-usuarios escucha las reseñas y los tickets y los convierte en algo que QA puede verificar.
analista-feedback-usuarios usa tokens
Trae reseñas de App Store (feed público) y de Google Play (exporte de Play Console) y tickets de Zendesk, Freshdesk o Intercom, enmascara los datos personales, agrupa por tema, versión y semana, detecta los temas que se dispararon con una versión, y propone bugs candidatos con su evidencia y los flujos que nadie prueba.
npm run feedback -- traer appstore --app-id 1234567890 --pais ar --carpeta output/feedback/mi-app
npm run feedback -- analizar --carpeta output/feedback/mi-appSin datos personales: el autor no se guarda y emails, teléfonos, documentos y tarjetas se enmascaran antes de escribir nada. Salida en output/feedback/<app>/.
Trazabilidad en la herramienta
El analista-trazabilidad verifica que la cadena épica → historia → caso → ejecución → bug esté conectada en Jira, Xray o Azure DevOps.
analista-trazabilidad usa tokens
Junta épicas, historias, casos, ejecuciones y bugs (por MCP o exportes) y detecta historias cerradas con bugs graves abiertos o sin ejecuciones, historias sin casos, épicas cerradas con historias abiertas, casos huérfanos o nunca ejecutados, bugs sin historia y links rotos, con el % de trazabilidad por épica y el árbol completo. Las correcciones se aplican solo con tu confirmación. Distinto del analista-cobertura, que mira los criterios de aceptación.
python scripts/trazabilidad.py importar input/trazabilidad/jira.csv --datos output/trazabilidad/PROJ/datos.json
python scripts/trazabilidad.py analizar --datos output/trazabilidad/PROJ/datos.jsonSolo lectura. Salida en output/trazabilidad/<proyecto>/.
Migrar automatización a k0lmena
El migrador-automatizacion pasa a k0lmena la automatización que el equipo ya tiene, sin perder casos ni IDs.
migrador-automatizacion usa tokens
Analiza el código sin ejecutarlo (Selenium en Java, Python, JS o C#, Cypress, Playwright suelto, WebdriverIO y colecciones de Postman, Bruno e Insomnia): tests, pasos, localizadores con su calidad, verificaciones y hooks. Arma el inventario con el % que se migra solo y un borrador de features, locators y steps; conserva los CP-XXX y deja los demás IDs como referencia. Lo que no tiene equivalente queda @bloqueado con el motivo, y las credenciales nunca se copian. Después lo verifica contra la app con el web-mapper o el api-mapper.
npm run migrar -- --origen ruta/a/la/suite --nombre tienda --historia HU-001El borrador queda en output/migracion/<suite>/borrador/: pasa a herramientas/k0lmena solo con tu confirmación.
Revisión de la automatización
El revisor-automatizacion revisa el código de las pruebas: lo que las vuelve lentas, inestables o engañosas.
revisor-automatizacion usa tokens
En cualquier framework (Cypress, Playwright, Selenium, WebdriverIO, pytest, JUnit, NUnit, Cucumber): esperas fijas, .only olvidados, tests sin aserciones o con aserciones tragadas, lógica en el test, selectores frágiles, credenciales y URLs fijas, estado compartido, reintentos, tests largos y Gherkin imperativo o sin @HU/@CP. Confirma cada hallazgo en su contexto, da un puntaje por archivo y una decisión sugerida, y deja los comentarios listos para el PR. El código de la aplicación lo revisa el revisor-codigo.
npm run revisar-tests -- --ruta cypress/e2e
npm run revisar-tests -- --manifiesto output/revision-codigo/<repo>/origen.json --solo-cambiosSolo lectura: no ejecuta ni modifica los tests; publicar los comentarios en el PR se confirma. Salida en output/revision-automatizacion/.
Anonimización de datos
El anonimizador-datos convierte un exporte real en datos de prueba sin personas identificables.
anonimizador-datos usa tokens
Lee CSV, JSON, JSONL, Excel y dumps SQL. Detecta la PII por nombre de columna y por contenido con validación real (email, DNI, CUIT/CUIL, RUT, CPF, teléfono, tarjeta con Luhn, CBU/CVU, IBAN, nombres, direcciones, fecha de nacimiento, IP y texto libre) y la reemplaza con valores falsos de formato válido, consistentes en todas las tablas gracias a un HMAC con el secreto del .env. Arma subconjuntos que respetan las relaciones y, al final, verifica que no quede PII en la salida.
npm run anonimizar -- --entrada exportes/ --solo-detectar
npm run anonimizar -- --entrada exportes/ --subconjunto 500 --clave cliente_idNunca toca los originales ni escribe en una base de datos, y el informe nunca muestra un valor original. Salida en output/anonimizacion/<nombre>/datos/.
Notificaciones: SMS, OTP, WhatsApp y push
El probador-notificaciones comprueba que cada SMS, OTP, WhatsApp o push llegue, a tiempo y bien escrito.
probador-notificaciones usa tokens
El buzón local imita las API de Twilio, Vonage, WhatsApp Cloud, FCM y APNs: la app de QA apunta su proveedor ahí y todo lo que manda queda atrapado. También lee el número de prueba de Twilio. Verifica llegada y tiempo, contenido, placeholders, OTP (largo, no trivial, no reutilizado, vencimiento), codificación y segmentos SMS, baja, idioma, links y duplicados, con teléfonos y códigos enmascarados.
npm run notificaciones -- buzon
npm run notificaciones -- verificar input/notificaciones/espera-HU-001.jsonMandar mensajes reales o push a dispositivos se confirma. Salida en output/notificaciones/<HU>/.
Feature flags y A/B tests
El probador-experimentos decide qué combinaciones de flags probar y si un experimento está bien hecho.
probador-experimentos usa tokens
Lee los flags en solo lectura (LaunchDarkly, Unleash, Flagsmith, GrowthBook o un exporte) y arma la matriz pairwise que cubre cada par de valores respetando las dependencias, más las combinaciones críticas. Detecta flags obsoletos, sin dueño y dependencias rotas o circulares, y valida los A/B: reparto con chi-cuadrado (SRM), asignación persistente y que analytics registre la variante.
npm run experimentos -- leer --proveedor launchdarkly --ambiente qa --salida output/experimentos/checkout/flags.json
npm run experimentos -- analizar output/experimentos/checkout/flags.json --criticas input/experimentos/criticas.jsonCambiar flags en el proveedor se confirma; los tokens son de solo lectura. Salida en output/experimentos/.
Evidencia para auditorías
El auditor-evidencias prepara lo que un auditor va a pedir, y muestra los huecos antes de la auditoría.
auditor-evidencias usa tokens
Junta lo que ya dejó K0lmenIA (historias, casos, ejecuciones con sus capturas, npm test, bugs, plan, cierre, seguridad y gestión), arma la matriz requisito → caso → ejecución → evidencia → bug y la mapea a ISO/IEC/IEEE 29119-3, IEC 62304, PCI DSS, SOX ITGC e ISO/IEC 27001 A.8.29. Requisitos sin casos, ejecuciones sin evidencia, bugs abiertos o aprobaciones que faltan quedan como hallazgos. Entrega un ZIP con un manifiesto SHA-256 de cada archivo y el informe.
npm run evidencias -- armar --nombre release-2.4 --aprobaciones input/evidencias/aprobaciones.json
npm run evidencias -- verificar output/evidencias/release-2.4/paquete-release-2.4.zip --hash <hash>Integridad, no autoría: el paquete no está firmado. Registrá el hash del manifiesto fuera del paquete (ticket de la release o acta) y verificalo con --hash. El mapeo a los marcos es orientativo y no reemplaza al auditor. Salida en output/evidencias/<release>/.
Presentación de resultados
El presentador-resultados convierte lo que QA ya midió en una presentación que lleva a una decisión.
presentador-resultados usa tokens
Toma el informe de cierre, el tablero, las métricas, la estrategia y los bugs, elige qué mostrar según la audiencia (una idea por diapositiva) y entrega diapositivas HTML 16:9 en español e inglés, con modo presentador e impresión a PDF, y un PowerPoint editable con gráficos nativos y las notas del orador.
npm run presentacion -- input/presentaciones/presentacion.ejemplo.json output/presentaciones/sprint-14/presentacion.htmlTeclas: flechas o espacio, F pantalla completa, P modo presentador, ? ayuda. El PowerPoint necesita pip install python-pptx. Salida en output/presentaciones/<nombre>/.
Refinamiento con tres amigos
El mejor momento para encontrar un bug es antes de que exista.
refinamiento-tres-amigos skill
Claude lee la historia completa, llega con un borrador y acompaña la sesión de negocio, desarrollo y QA: Definition of Ready e INVEST, el mapa de ejemplos (reglas, ejemplos concretos positivos, negativos y de borde, preguntas abiertas como FI-XX e historias derivadas), los criterios de aceptación con sus ejemplos, los riesgos, los datos y el esfuerzo de prueba. Después propone pasar los ejemplos a BDD.
python scripts/generar_informe_refinamiento.py output/refinamiento/HU-012/refinamiento.json output/refinamiento/HU-012/informe-refinamiento.htmlEscribir en Jira o Azure DevOps (criterios, comentarios, subtareas) se confirma. Salida en output/refinamiento/<HU>/.
Mapa de riesgo
Dónde poner el esfuerzo de prueba de una release, decidido con datos.
mapa-de-riesgo usa tokens
Cruza los cambios en el código (git: líneas, commits, autores y complejidad) con los bugs, los errores de producción, la cobertura de código, el uso real y el impacto de negocio de cada módulo. Arma un mapa de calor con un puntaje explicable (probabilidad × impacto), el esfuerzo sugerido y qué probar en cada módulo. Los módulos se definen en input/riesgo/modulos.json.
npm run riesgo -- --nombre release-2.4 --repo ../mi-app --rango v2.3..v2.4Solo lectura sobre el repo y las fuentes. Un factor sin datos no pesa y el informe lo dice. Salida en output/riesgo/<release>/.
Depuración de la suite
Una regresión más corta y confiable: lo que sobra, lo que se repite y lo que ya no sirve.
depurador-suite usa tokens
Sobre el inventario local y los exportes de la herramienta de gestión detecta duplicados, casos obsoletos, nunca ejecutados, inestables crónicos, demasiado largos, sin trazabilidad y automatizados que siguen en la regresión manual. Propone qué consolidar, retirar, estabilizar o automatizar, con el ahorro de tiempo por ciclo.
npm run depurar-suite -- --nombre regresion --importar input/depuracion/casos.csvNo borra ni cambia casos: retirar o unir se hace con tu aprobación. Salida en output/depuracion-suite/<suite>/.
Flujos reales de los usuarios
Probar lo que los usuarios usan de verdad, no solo lo que alguien imaginó.
analista-flujos-reales usa tokens
Trae en solo lectura los recorridos de Google Analytics 4 y las páginas de entrada de Google Search Console (o importa sesiones y logs de acceso), arma los flujos más frecuentes con su volumen y conversión, los cruza con los casos existentes y genera casos de prueba (planilla .xlsx) y borradores BDD (.feature) para los que nadie prueba. Con GA4 solo, los flujos son estimados; con sesiones o logs, exactos.
npm run flujos-reales -- traer-ga4 --propiedad 123456789 --carpeta output/flujos-reales/mi-sitio
npm run flujos-reales -- analizar --carpeta output/flujos-reales/mi-sitioCredenciales solo en el .env (GA4_CREDENCIALES, GSC_SITIO). Los casos generados llevan "Falta información" para que el PO complete el resultado de negocio. Salida en output/flujos-reales/<sitio>/.
Cobertura de código
El analista-cobertura-codigo dice qué no está probado y si el código nuevo de un PR trae tests.
analista-cobertura-codigo usa tokens
Lee los reportes de cobertura que ya generan los frameworks (JaCoCo, Istanbul/LCOV, coverage.py, Cobertura, OpenCover), sin correr los tests. Calcula la cobertura global, por módulo y del cambio (diff coverage del PR), encuentra los archivos sin cubrir y mapea los huecos a funcionalidades con su riesgo. Distinto del analista-cobertura, que cruza criterios de aceptación con casos.
python scripts/cobertura_codigo.py analizar coverage/lcov.info --diff main...HEAD --umbral-diff 80No corre los tests de la app: lee el reporte ya generado. Salida en output/cobertura-codigo/<nombre>/.
Seguridad de APIs (OWASP API Top 10)
El probador-seguridad-api prueba la seguridad de una API donde más falla: la autorización.
probador-seguridad-api usa tokens
Con el contrato y usuarios de prueba por rol, verifica el OWASP API Security Top 10: BOLA/IDOR, autenticación rota, BFLA, mass assignment, exposición de datos, rate limiting, SSRF, CORS, headers e inventario, y arma la matriz rol × endpoint con el CWE de cada hallazgo. Complementa al analista-seguridad y al pentester-web (capa web).
npm run seguridad-api -- probar --contrato input/api/openapi.yaml --url https://qa.mi-api.com --roles input/seguridad-api/roles.jsonSolo APIs propias o autorizadas, en QA. Por defecto solo lectura; la escritura se confirma. Salida en output/seguridad-api/<api>/.
Migraciones de base de datos
El probador-migraciones-bd encuentra las migraciones que borran datos o rompen la app anterior, antes de aplicarlas.
probador-migraciones-bd usa tokens
Analiza los scripts (Flyway, Liquibase, Alembic, Django, Rails, Knex/TypeORM, SQL) y marca operaciones destructivas, NOT NULL sin default, renombres y cambios de tipo (compatibilidad expand/contract), bloqueos en tablas grandes y migraciones sin rollback. En una base de QA descartable verifica up/down, idempotencia y datos preservados.
python herramientas/migraciones_bd/migraciones.py analizar db/migrate --tabla-grande pedidos,usuariosEl análisis estático no toca ninguna base; la prueba up/down, solo una base de QA descartable confirmada. Salida en output/migraciones-bd/<nombre>/.
Reuniones
El analista-reuniones pasa la transcripción de una reunión a decisiones y acciones a tomar.
analista-reuniones usa tokens
Lee transcripciones de Teams, Zoom, Meet, Granola u Otter (.vtt, .srt, .txt, .docx) y arma: decisiones, acciones a tomar con responsable, fecha y el agente que ayuda, criterios de aceptación y casos de prueba afectados, FI resueltas, preguntas abiertas, riesgos y cambios de alcance, más la participación y los temas a lo largo de la reunión. Enmascara emails, teléfonos y documentos.
npm run reuniones -- input/reuniones/refinamiento.vtt --tipo refinamiento --fecha 2026-10-28Nada se carga en Jira o Azure DevOps sin confirmación. Salida en output/reuniones/<nombre>/.
Atajos de flujos frecuentes
Un comando para los recorridos de todos los días, con un informe del flujo que linkea a lo que dejó cada paso.
| Atajo | Qué hace |
|---|---|
/k0lmenia:flujo-historia PROJ-12 | Contexto, análisis, casos y BDD, automatización, ejecución e informe. |
/k0lmenia:flujo-bug | Reporte, duplicados, causa raíz en el código y carga con confirmación. |
/k0lmenia:flujo-release v2.4 | Ambiente, mapa de riesgo, selección, ejecución, fallos, cierre y presentación. |
/k0lmenia:flujo-pr | Revisión de código y de tests, cobertura del cambio, casos afectados y comentarios. |
/k0lmenia:flujo-sprint | Métricas, tablero, trazabilidad, cierre y presentación. |
/k0lmenia:flujo-post-release | Errores de producción, feedback, trazabilidad y bugs. |
/k0lmenia:flujo-auditoria | Trazabilidad, cobertura, paquete de evidencias y presentación. |
Cada atajo pregunta todo al principio, confirma lo que tiene efecto (cargar en Jira, publicar, mandar mensajes) y deja su informe en output/flujos/. En el repo clonado se escriben sin el prefijo: /flujo-historia.
Resumen diario a Slack y Teams
Lo que el equipo necesita antes de la daily, todos los días, con un informe completo detrás del botón.
/k0lmenia:resumen-diario
Primero lo más importante: el estado de las pruebas (último npm test, qué se rompió desde la corrida anterior, el CI y las ejecuciones en curso de Xray o Azure Test Plans con su avance y % aprobado) y los bugs abiertos y críticos (Jira o Azure DevOps); después producción, usuarios, sprint y ambiente. Solo aparece lo que elegís y está configurado. Corre en GitHub Actions, como tarea programada en tu PC o como rutina de Claude Code; por defecto, de lunes a viernes a las 9:00.
npm run resumen -- validar
npm run resumen -- generar --simular
npm run resumen -- programar --modo github --confirmarMandar y programar tienen efecto: se confirman. Las credenciales van en el .env o como secretos de GitHub, nunca en el chat. Informe en output/resumen/<fecha>/.
Historial de corridas
Cada herramienta guarda sus últimas 5 corridas con su evidencia, así podés comparar antes y después de un arreglo sin perder nada.
| Dónde | Qué guarda |
|---|---|
output/<herramienta>/<HU o sitio>/historial/<fecha-hora>/ | El JSON, el análisis, el informe y la evidencia (capturas, videos, recortes) de cada corrida anterior: su informe se sigue abriendo igual. |
herramientas/k0lmena/reports/<suite>/historial/ | El reporte de Cucumber y la evidencia de cada npm test anterior (capturas, videos, traces y el DOM al fallar). |
Nuevos
Lo que aparece en esta corrida y no estaba en la anterior.
Resueltos
Lo que estaba y ya no aparece.
Evolución
Los indicadores principales de cada corrida en el tiempo, con el link al informe de cada una.
Cada informe (exploratorias, accesibilidad, rendimiento, regresión visual, cross-browser, fallos, cobertura, reparaciones, selección, correos, traducciones, revisión de casos, charters, usabilidad, formularios y logs) trae la sección Evolución de las corridas. Para guardar más corridas: HISTORIAL_CORRIDAS=10 en el entorno de las herramientas de k0lmena.
Tablero de calidad y portal de informes
tablero-calidad usa tokens
Junta lo que ya dejaron las herramientas (ejecuciones, npm test y su historial, casos, cobertura, bugs, inestables, accesibilidad, rendimiento, performance y seguridad) y arma un dashboard con aprobados y tendencia, % automatizado, cobertura, bugs por severidad e historia, minutos de ejecución manual, alertas y un resumen para gerencia. Lo que no tiene datos dice "Sin datos".
npm run tablero -- --nombre sprint-12 --desde 2026-10-01 --hasta 2026-10-14
npm run portal -- --abrir   # output/index.html
Portal de informes
El portal (output/index.html) junta todos los informes. Antes de indexar arma el HTML de los artefactos de los agentes que no tienen informe propio: casos de prueba (también desde generar_casos.py), BDD legible con sus Examples, bugs, análisis de historias, datos, casos de API, contexto, triage, consultas, mapeos, verificaciones, la trazabilidad y los resultados publicados de la gestión de pruebas, y la documentación del proyecto (input/documentacion/, que se muestra en output/documentacion/ sin tocar input/).
| Qué tiene | Cómo |
|---|---|
| Tablero de inicio | Indicadores globales (npm test por suite con tendencia, bugs abiertos y críticos, informes de hoy), alertas de lo que hay que revisar, últimos veredictos (ambiente, riesgo, seguridad, cierre) y tarjetas por categoría con el último informe de cada herramienta; el buscador lleva a «Todos los informes» con filtros. |
| Menú por categoría | Inicio, Pruebas automatizadas, Ejecuciones, Diseño de pruebas, Bugs, Calidad y cierre (con los evals de los agentes), Web, Seguridad, Plataformas y Documentación (con el relevamiento del proyecto). |
| Historial completo | Cada corrida guardada en historial/ es una fila, no solo la última. |
| Filtros | Texto, herramienta, historia, estado y rango de fechas (24 h, 7 días, 30 días o desde/hasta), con la opción de ocultar las corridas anteriores; de a 100 filas. |
| Dos idiomas | output/es/index.html y output/en/index.html; output/index.html abre el que elegiste. Cada fila enlaza a la versión de ese idioma. |
Se regenera solo cada vez que se arma un informe y se abre con doble clic. Ver también Informes en español e inglés.
Informes en español e inglés
Cada informe sale en los dos idiomas, con una banderita para pasar de uno al otro, así elegís cuál mandar.
output/accesibilidad/app.com/
├── informe-accesibilidad.html      acceso: abre el idioma elegido (español por defecto)
├── es/informe-accesibilidad.html   español
├── en/informe-accesibilidad.html   inglés
└── capturas/ analisis.json …       evidencia y datos, compartidos por los dos idiomas
La banderita recuerda tu elección: el portal y los accesos abren siempre ese idioma. El historial guarda los dos idiomas de cada corrida. Para mandar un informe, mandás la carpeta del idioma junto con su evidencia.
| Qué se traduce | Cómo |
|---|---|
| Lo que escribe el agente | Veredicto, resumen, hallazgos y recomendaciones: el agente los escribe también en inglés en un bloque "en" del JSON del informe (mismas claves e IDs). En los artefactos escribe la versión al lado: BUG-001.en.md, analisis-HU-001.en.md, X.en.csv, y en el BDD HU-001-x.feature.en, que ningún runner toma. |
| La interfaz | Títulos, columnas, estados, gráficos y textos fijos: un diccionario de unas 2.300 entradas (scripts/i18n/en/), sin gastar tokens. Números, fechas e IDs son comodines. |
| Si falta la traducción | El informe en inglés sale igual: interfaz en inglés, contenido en español y un aviso. |
Contexto y documentación: en inglés a pedido
Las fichas de contexto, la documentación del proyecto, las consultas, los mapeos y las verificaciones de datos se escriben en español. Antes de armarlos, Claude pregunta si también los querés en inglés; con DOCUMENTACION_EN=si o no en el .env la respuesta queda fija y no vuelve a preguntar.
El CI corre los tests con el control estricto de traducciones (K0LMENIA_I18N_ESTRICTO): si un informe en inglés deja texto de la interfaz en español, la corrida falla. Para encontrar lo que falta: K0LMENIA_I18N_AUDITORIA=archivo.txt.
Avisos y monitoreo sintético
Avisos a Slack y Teams
scripts/avisar.py publica por webhook (SLACK_WEBHOOK_URL con Block Kit y TEAMS_WEBHOOK_URL de Teams Workflows con una Adaptive Card). Lo usan el triador (bug crítico), el tablero y el monitoreo, y se puede llamar después de npm test. Sin webhook configurado no manda nada.
npm run avisar -- --titulo "Regresión del sprint 12" --texto "3 fallidos" --nivel error --link https://…
npm run avisar -- --desde-cucumber herramientas/k0lmena/reports/web/cucumber-report.json
Monitoreo sintético
npm run monitorear hace un smoke de solo lectura contra cualquier ambiente: estado y tiempo de cada URL, texto esperado, certificado TLS por vencer y, si querés, escenarios de k0lmena con @sintetico. Compara con la corrida anterior y avisa solo cuando algo se rompe o se recupera. Se programa con .github/workflows/monitoreo.yml, cron o el Programador de tareas de Windows.
npm run monitorear -- --urls https://tu-app.com,https://tu-app.com/login --nombre produccionEvals de los agentes
Los tests cubren los scripts; los evals miden la calidad de lo que generan los agentes.
Cada caso de evals/casos/ le da a un agente una historia, un contrato, una observación o un repositorio con trampas deliberadas (ambigüedades, contradicción entre descripción y comentario, mensajes sin definir, límites, un secreto falso) y verifica con chequeos determinísticos que marque la Falta información, aplique valores límite, respete las plantillas y no invente. Corre en un workspace aislado con claude -p y deja un informe con el puntaje por agente y las regresiones contra la corrida anterior.
Hay 17 casos: análisis de historias, casos manuales, BDD, casos de API (REST y GraphQL), datos de prueba, reporte de bug, triage, revisión de código, documentación del proyecto, consultas, plan de pruebas, revisión de casos, charters, análisis de fallos, cobertura y selección de casos. Cada uno tiene una salida de referencia (lo que dejaría un agente correcto): --referencia la verifica sin gastar tokens y el CI la corre en cada cambio, así una modificación que rompa los chequeos o los scripts se detecta sola.
npm run evals -- --listar
npm run evals -- --referencia                         # sin tokens: lo corre el CI
npm run evals -- --correr --agente generador-casos-manuales
npm run evals -- --solo-verificar <carpeta> --caso casos-manuales-hu-registro # sin volver a correr el agenteCorrer los evals gasta tokens (cada caso es una conversación completa, con un tope por caso). Usalos antes y después de cambiar un agente o un skill.
Uso de tokens
Cuánto gasta cada agente y dónde conviene automatizar.
scripts/metricas_tokens.py lee las transcripciones de Claude Code de este proyecto (~/.claude/projects/): de cada respuesta del modelo toma los tokens de entrada, salida y caché y el modelo, nunca el texto. Atribuye el uso a cada agente (los subagentes por su tipo; lo demás es la conversación principal) y arma un informe con el costo estimado por agente, día y modelo, el porcentaje leído desde caché y oportunidades: los agentes que más gastan, los que se usan muchas veces para lo mismo (candidatos a automatizar en k0lmena, que después corre sin tokens) y la caché baja. Suma también el costo de los evals. El tablero de calidad muestra el resumen.
npm run metricas                                          # todo el historial
npm run metricas -- --nombre octubre --desde 2026-10-01 # un períodoEl costo es una estimación con la tabla de precios por millón de tokens del script (PRECIOS, con su fecha y fuente); no reemplaza la facturación real. Los modelos que no están en la tabla se informan como "sin precio".
Onboarding
Para que alguien que recién llega sea productivo rápido en este proyecto.
guia-onboarding usa tokens
Lee la documentación del proyecto (empieza por el índice que arma el documentador), corre npm run doctor, mira los conectores activos y lo que ya existe (historias, casos, automatización, informes) y arma un plan: el producto con sus módulos, flujos, roles y glosario (con la fuente de cada dato), el estado de su entorno, los agentes que le sirven según su rol con pedidos de ejemplo de este proyecto, las tareas de las primeras semanas con su criterio de "hecho", las preguntas para el equipo sobre lo que no está documentado y un checklist que se tilda en el navegador. Sale en output/onboarding/<persona>/ como HTML y Markdown.
Seguridad web
El analista-seguridad revisa la seguridad de tu aplicación con OWASP ZAP (libre y gratuito) en modo pasivo: recorre el sitio y analiza las respuestas sin enviar ataques ni modificar datos.
Solo se escanean sitios propios o con autorización por escrito, declarados en SEGURIDAD_URLS_AUTORIZADAS del .env. Un escaneo pasivo no reemplaza una prueba de penetración.
analista-seguridad
- Confirma la URL (tiene que estar autorizada) y la duración del recorrido.
- Escanea con ZAP baseline en Docker (abrí Docker Desktop antes).
- Analiza los hallazgos: los prioriza, descarta falsos positivos con su motivo y los explica en español.
- Arma el informe HTML: hallazgos por riesgo, dónde aparece cada uno, evidencia, cómo se corrige y recomendaciones.
python herramientas/zap/escanear.py --url https://staging.mi-app.com --historia HU-001Salida en output/seguridad/<HU o host>/<fecha>/. Detalle en herramientas/zap/README.md.
pentester-web
- Confirma la URL (autorizada), la autorización del pentest activo (
PENTEST_AUTORIZADO=si), el ambiente (no producción sin permiso) y el alcance. - Escanea activo con ZAP full scan (envía ataques) y hace verificación manual del OWASP Top 10 con Playwright: control de acceso e IDOR, autenticación y sesión, inyección, XSS, configuración, CSRF/SSRF.
- Confirma cada hallazgo (descarta falsos positivos) y mide el impacto real en tu sitio.
- Arma el informe HTML (modo activo) y un
reporte-pentest.mdcon pasos para reproducir y cómo corregir.
python herramientas/zap/escanear.py --url https://staging.mi-app.com --historia HU-001 --activo --confirmarEthical hacking autorizado: solo URLs de SEGURIDAD_URLS_AUTORIZADAS, con PENTEST_AUTORIZADO=si, sobre un sitio propio o con permiso escrito y nunca contra producción sin autorización. No es destructivo.
Streaming y cámaras
Cinco agentes para QA de video y cámaras de seguridad: verificar que el stream reproduzca bien, controlar la cámara por ONVIF, revisar la calidad de imagen, chequear las grabaciones y analizar la seguridad de los dispositivos. Cubren cámaras IP (RTSP/ONVIF), transmisiones en vivo (RTMP/HLS/DASH), WebRTC servido por HTTP y playback de VOD.
Solo dispositivos o streams propios o con autorización por escrito, declarados en STREAMING_FUENTES_AUTORIZADAS, ONVIF_HOSTS_AUTORIZADOS o CAMARAS_AUTORIZADAS del .env. Todo es de solo lectura (no graba ni retransmite), salvo el PTZ, que mueve la cámara y se confirma.
probador-streaming
- ffprobe lee las propiedades: códec, resolución, FPS, bitrate, audio y keyframes (GOP).
- ffmpeg mide la latencia de arranque, la continuidad (frames caídos, errores) y, con
--estabilidad, un soak con reconexión; con--conexiones, una prueba de carga acotada. - Arma el informe HTML con las propiedades, la continuidad y los hallazgos por severidad.
npm run streaming -- --fuente rtsp://cam.local/stream --estabilidad 60 --conexiones 10 --confirmarprobador-onvif
- Lee info del dispositivo, capacidades, perfiles y URIs de stream, snapshot y eventos.
- Chequea el reloj (deriva vs. la hora real), la zona horaria, el NTP y el firmware contra el estándar del sitio.
- PTZ opcional (
--ptz --confirmar): mueve la cámara un mínimo y la frena. Devuelve la URI RTSP para el probador-streaming. - Eventos en vivo (
--eventos N): se suscribe por pull-point y espera N segundos a que llegue un evento real de movimiento (generá movimiento frente a la cámara).
npm run onvif -- --host 192.168.1.50 --confirmarcalidad-imagen
- OpenCV detecta frames negros, desenfoque y congelamiento (y, con una referencia, si la cámara se movió).
- Con visión, el agente mira la captura y juzga lente sucia u obstruida, contraluz e IR que no conmuta de noche.
- Arma el informe con la captura, las métricas y los hallazgos por cámara.
npm run calidad-imagen -- --fuente rtsp://cam.local/stream --referencia ref.jpg --confirmarverificador-grabaciones
- Consulta por ONVIF (Recording/Search) el rango grabado, la cantidad y los tracks.
- Detecta huecos y compara los días cubiertos con la retención esperada; avisa si la última grabación es vieja.
- Si el dispositivo no lo soporta por ONVIF, lo informa (puede necesitar la API del NVR).
npm run grabaciones -- --host 192.168.1.60 --retencion 30 --confirmaranalista-seguridad-camaras
- Escaneo pasivo de puertos y servicios inseguros: Telnet, FTP, HTTP sin TLS, RTSP sin autenticación.
- Lee el firmware (si hay credenciales ONVIF) y recuerda revisar sus CVEs. No prueba credenciales ni ataca.
- Arma el informe con los puertos, los servicios inseguros y los hallazgos por cámara.
npm run seguridad-camaras -- --host 192.168.1.50,192.168.1.51 --confirmarRequisitos: ffmpeg (streaming y calidad de imagen) y, para ONVIF y calidad, onvif-zeep y opencv-python-headless (se instalan solas). Salida en output/streaming/.
Conectores MCP
Conectan a Claude Code con sistemas externos. Claude Code arranca directo: vienen activos Playwright y Atlassian, y cada QA activa el resto con npm run conector. Sin secretos: las credenciales se leen del .env. Vienen activos Playwright y Atlassian (Jira y Confluence); el .env.example trae un bloque comentado por herramienta para completar solo los de tu equipo.
| Conector | Para qué | Autenticación |
|---|---|---|
playwright | Navegador para el ejecutor E2E y el web-mapper (headed y headless). | Activo |
atlassian | Jira y Confluence: historias, criterios y documentación funcional directamente. Con token, también Bitbucket Cloud. | Activo · OAuth o API token |
figma | Diseños desde un link a un frame o archivo: textos, estados y componentes. Requiere asiento Full o Dev. | Cuenta (OAuth) |
appium-mcp | Lo usa el mobile-mapper para recorrer la app. | ANDROID_HOME |
qmetry · qtm4j | Consultar QMetry desde el chat. | API key |
aio-tests | Consultar AIO Tests desde el chat. | Token |
azure-devops | Azure DevOps: historias, Wiki, Azure Repos y casos en Test Plans. | PAT |
linear · clickup · monday · asana · trello · notion · youtrack · shortcut | Historias y documentación si tu equipo no usa Jira ni Azure DevOps (servers MCP oficiales). | Cuenta (OAuth); YouTrack con token; Asana con app propia |
github · gitlab | Repositorio de la app para el documentador-proyecto (código, PRs y commits, solo lectura). | Token (GitLab: también OAuth) |
k0lmena-tmt | Consultar k0lmenaTMT desde el chat (casos, planes, estadísticas). Las cargas van por scripts/gestion/. | Token personal |
scalar | APIs que están en Scalar: buscar y ejecutar lecturas, y el contrato del Registry (probador-scalar). | SCALAR_MCP_URL · SCALAR_API_KEY |
sentry · sentry-local · datadog · newrelic | Observabilidad: errores de producción para el analista-produccion, el mapa-de-riesgo y la causa raíz. Servidores oficiales (New Relic en preview). | OAuth o token |
google-analytics · search-console | Analytics y búsqueda: flujos reales de los usuarios y páginas de entrada para el analista-flujos-reales. Google Analytics es el oficial de Google; Search Console, comunitario. | Cuenta de servicio de Google |
intercom | Conversaciones de soporte para el analista-feedback-usuarios. Zendesk y Freshdesk todavía no tienen un MCP confiable: se leen por API con npm run feedback. | OAuth o token |
testrail · browserstack · sauce-labs · postman | Plataformas de testing: TestRail (comunitario, solo lectura), dispositivos y navegadores reales, colecciones y entornos. | Token / access key |
npm run conector -- listar --html deja output/conectores/estado.html con el estado de cada conector (activo, listo para activar o con datos faltantes), sin mostrar valores del .env.
- Completá el .envSi usa token, cargalo en el
.envde la raíz. Atlassian y Figma se autorizan con tu cuenta desde/mcp. - Activalo
npm run conector -- activar azure-devops(queda solo para vos;npm run conectorlista los disponibles). - VerificáReiniciá Claude Code y revisá la conexión con
/mcp.
Para Xray y Zephyr Scale no hace falta MCP: se usa scripts/gestion/. k0lmenaTMT también carga por scripts/gestion/ (que habla con su server MCP sin el modelo); el conector queda para consultas. Con el plugin, Playwright y Atlassian vienen dentro del plugin. Guía completa en CONECTORES.md.
Convenciones
| Elemento | Formato |
|---|---|
| Historias | HU-001 |
| Criterios de aceptación | CA1 · CA2 |
| Casos manuales | CP-001 |
| Casos de API | CP-API-001 |
| Bugs | BUG-001 |
| Falta información | FI-01 · @falta-info @FI-01 |
| Escala | Valores |
|---|---|
| Severidad y prioridad | Crítica · Alta · Media · Baja |
| Estado de un caso | N/A · Pendiente · En ejecución · Aprobado · Fallido · Bloqueado |
Tags en k0lmena
| Dónde | Tags |
|---|---|
| Feature | La historia y el tipo: @HU-001 @web · @api · @mobile |
| Scenario | El ID del caso (@CP-001, @CP-API-001) y @smoke si es crítico |
| Excluir | @bloqueado: un paso no se pudo verificar y el escenario no se ejecuta |
Nombres de archivos
| Artefacto | Nombre |
|---|---|
| Análisis | analisis-HU-001.md |
| Casos manuales | casos-HU-001.xlsx + .md + -cobertura.md |
| Casos BDD | HU-001-registro.feature + HU-001-cobertura.md |
| Bug | BUG-001.md |
| Automatización | <tipo>/features/HU-001-<slug>.feature · steps/HU-001.steps.ts · locators/HU-001.locators.ts |
| Performance | performance/k6/http/HU-001-<slug>.ts · performance/artillery/HU-001-<slug>.yaml · performance/jmeter/HU-001-<slug>.jmx |
| Mapeo | output/mapeos/mapeo-HU-001-<tipo>.md |
| Exploratorias | output/exploratorias/<HU o sitio>/informe-exploratorio.html + exploracion.json · capturas/ · videos/ · historial/ (últimas 5) |
| Rendimiento web | output/rendimiento/<HU o sitio>/informe-rendimiento.html + rendimiento.json · capturas/ · lighthouse/ |
| Análisis de fallos | output/fallos/<HU o suite>/informe-fallos.html + fallos.json · corridas/ · evidencia/ |
| Cobertura | output/cobertura/<HU o todas>/informe-cobertura.html + cobertura.json |
| Regresión visual | output/pixel-perfect/<HU o sitio>/informe-pixel-perfect.html + pixel-perfect.json · referencia/ (se conserva) · actual/ · diferencias/ · recortes/ |
| Cross-browser | output/cross-browser/<HU, sitio o suite>/informe-cross-browser.html + cross-browser.json · capturas/ · suite/ |
| Reparaciones | output/reparaciones/<HU o suite>/informe-reparacion.html + reparaciones.json · cambios.diff · respaldo/ |
| Selección de casos | output/seleccion-casos/<nombre>/informe-seleccion.html + seleccion.json · seleccion.csv |
| Accesibilidad | output/accesibilidad/<HU o sitio>/informe-accesibilidad.html + auditoria.json · capturas/ · videos/ · historial/ (últimas 5) |
| Correos | output/correos/<HU o buzón>/informe-correos.html + correos.json · capturas/ · eml/ |
| Traducciones | output/traductor/<HU o sitio>/informe-traductor.html + traductor.json · capturas/ · recortes/ |
| Revisión de casos | output/revision-casos/<HU o nombre>/informe-revision.html + revision.json |
| Charters | output/charters/<HU o nombre>/charters.html + charters.md · sesiones/CH-XX.md · informe-sesiones.html |
| Usabilidad | output/ux/<HU o sitio>/informe-ux.html + ux.json · capturas/ · recortes/ |
| Formularios | output/formularios/<HU o sitio>/informe-formularios.html + formularios.json · capturas/ |
| Logs | output/logs/<nombre>/informe-logs.html + logs.json |
| Historial | <carpeta de cada herramienta>/historial/<fecha-hora>/ (últimas 5, con su evidencia) · herramientas/k0lmena/reports/<suite>/historial/ para npm test |
Estructura del repositorio
k0lmenIA/
├── CLAUDE.md               Contexto y estándares (Claude Code lo lee siempre)
├── REFERENCIA.md           Salida de cada agente, scripts y nombres de archivos (se lee a pedido)
├── ARQUITECTURA.md         Cómo crece el repo
├── CONECTORES.md           Cómo activar los conectores MCP
├── CHANGELOG.md            Cambios de cada versión
├── LICENSE                 Licencia MIT
├── .env.example            Plantilla de variables (copiar a .env)
├── .mcp.json               Conectores MCP (sin secretos; activos según settings)
├── package.json            Atajos de npm (los de Python, con node scripts/py.js)
├── bin/                    k0lmenia: el comando del plugin (init, actualizar, py, ayuda…)
├── docs/                   Este sitio y los diagramas (el PDF se publica en el release "docs")
├── tests/                  Tests de los scripts (pytest y node --test)
├── evals/                  Evals de los agentes: 17 casos con trampas, chequeos y salidas de referencia
├── .github/workflows/      CI (tests y navegador real), plugin, PDF, monitoreo y evals (manuales)
├── .claude/
│   ├── agents/             Los 104 agentes
│   ├── skills/             Los 87 skills: contexto, diseño, ejecución, k0lmena y cada plataforma
│   └── settings.json       Conectores habilitados y permisos
├── input/                  historias/ documentacion/ api/ bugs/ correos/ logs/
├── output/                 Lo que generan los agentes
├── plantillas/             Bug, planilla de casos, cobertura, tiempo estimado
├── scripts/                Casos, tiempo estimado, revisión, charters, logs, informes, portal, doctor y armado del plugin
│   ├── i18n/en/            Diccionarios de los informes en inglés
│   ├── gestion/            Xray, QMetry (QTM4J), AIO Tests, Zephyr Scale, k0lmenaTMT y casos para Azure DevOps
│   └── mcp/                Lanzadores de los conectores MCP (leen el .env)
└── herramientas/
    ├── newman/         Colecciones de Postman, Bruno e Insomnia
    ├── zap/            OWASP ZAP: seguridad web (pasivo)
    ├── mailpit/        Mailpit: buzón de prueba para los correos
    ├── ci/             Plantillas de pipeline (GitHub, GitLab, Jenkins, Azure)
    ├── analytics/      Analytics y píxeles: análisis y confirmación por API
    ├── chatbots/       Guiones de conversación contra chatbots
    ├── virtualizacion/ Mocks de servicios (formato WireMock)
    ├── fuzzing/        Fuzzing de APIs con Schemathesis
    ├── ambiente/       ¿Listo para probar? Verificación de ambiente
    ├── produccion/     Errores de producción (Sentry, Datadog, New Relic)
    ├── feedback/       Reseñas y tickets sin datos personales
    ├── migracion/      Migración de suites a k0lmena
    ├── revision_tests/ Revisión estática del código de pruebas
    ├── anonimizacion/  Anonimización de datos para QA
    ├── notificaciones/ SMS, WhatsApp y push: buzón local y verificación
    ├── experimentos/   Feature flags y A/B: pairwise, obsoletos y chi-cuadrado
    ├── codigo/         Traer el código y revisión estática
    ├── contenido/      Typos y textos de relleno
    ├── desktop/        Árbol de controles de apps de escritorio
    ├── documentos/     PDF y Excel/CSV generados
    ├── ecommerce/      Shopify, WooCommerce, PrestaShop y VTEX
    ├── manual/         Manual de usuario
    ├── mensajeria/     Kafka, RabbitMQ, MQTT, WebSocket y SSE
    ├── mutacion/       Reportes de mutation testing
    ├── observabilidad/ Healthchecks y métricas Prometheus
    ├── resiliencia/    Caos server-side con Toxiproxy
    ├── salesforce/     Inventario de una org con la CLI sf
    ├── sap/            SAP GUI Scripting
    ├── scalar/         APIs en Scalar
    ├── seguridad/      SCA de dependencias y SAST
    ├── seo/            Relevamiento de SEO y GEO
    ├── soap/           Servicios SOAP desde el WSDL
    ├── streaming/      Video, cámaras y grabaciones (ffmpeg, ONVIF, OpenCV)
    ├── flujos/         Flujos reales de los usuarios (GA4, Search Console)
    ├── seguridad_api/  OWASP API Top 10 sobre un ambiente de QA
    ├── migraciones_bd/ Riesgos y prueba up/down de migraciones de BD
    ├── reuniones/      Transcripciones de reuniones → decisiones, acciones y casos afectados
    ├── mobile/         Chequeos de publicación de APK/AAB/IPA
    └── k0lmena/
        ├── web/            features/ steps/ locators/ + framework
        ├── api/            features/ steps/ (steps genéricos)
        ├── mobile/         features/ steps/ locators/ support/ apps/
        ├── performance/    k6/http/, artillery/ y jmeter/
        ├── tools/navegador/ Navegador común: canal, bypass anti-bots y detección de bloqueos
        ├── reports/        Reportes HTML
        ├── run-tests.js    Runner de npm test
        └── run-perf.js     Runner de npm run perf
Problemas frecuentes
¿Qué pasa si a la historia le falta información?
FI-01) con la pregunta para el PO, y se marca en los casos, los .feature y todos los reportes. Nunca se completa con lo que hace la app.No sé qué me falta instalar o configurar
npm run doctor: revisa por secciones Python, Node, k0lmena, Playwright, Newman, Java, Docker, las fuentes, el .env (también que cada integración esté completa y coherente, sin mostrar secretos), los conectores habilitados, git y lo que necesitan el portal, el monitoreo y los evals, y dice cómo resolver lo que falta. Con --seccion revisa solo una parte y con --rapido saltea lo lento.La app detecta bots y frena a Playwright o a los agentes
QA_BYPASS_HEADER y QA_BYPASS_TOKEN en el .env, el header se manda solo a los hosts de la app. También sirven una lista blanca de IP o las claves de prueba del captcha. Mientras tanto, npm run login abre tu Chrome para resolverlo a mano, y NAVEGADOR_CANAL=chrome usa el Chrome instalado. Guía para el equipo de la app: herramientas/k0lmena/tools/navegador/README.md.Si instalo el plugin, ¿pierdo mis cambios cuando se actualiza?
input/, output/, .env y herramientas/k0lmena/ con tus pruebas no se tocan. El núcleo de k0lmena se actualiza a pedido con k0lmenia actualizar, que no toca tus features/, steps/ ni locators/. Si personalizaste un agente, hacelo con una copia en .claude/agents/ de tu proyecto, nunca editando la caché.Un informe abre en inglés y lo quiero en español (o al revés)
es/ y en/, al lado del acceso.El link para descargar el PDF da error
documentacion.yml en el release docs cuando cambia docs/. Si todavía no corrió, se lanza desde GitHub → Actions → Documentación en PDF → Run workflow. En tu PC: node docs/generar.js.Un agente devuelve "Necesito que confirmes"
Un agente nuevo no aparece
La suite web falla sin URL o los clics dicen "outside of the viewport"
.env de la raíz (cp .env.example .env) o BASEURL/APP_URL. Lo del viewport ya está corregido: si VIEWPORT_WIDTH y VIEWPORT_HEIGHT están vacíos, la ventana usa 1366x768. Si un test falla porque cambió un locator, pedile al reparador-automatizacion que lo arregle.npm test corre 0 escenarios
TAGS no coincide con ningún escenario.Un escenario nunca se ejecuta
@bloqueado: el mapper no pudo verificar un paso. El motivo está en un comentario arriba del escenario."No encuentro k6"
npm run bootstrap:k6 en herramientas/k0lmena/ o instalá k6 en el PATH."No encuentro JMeter" o "JMeter necesita Java"
npm run bootstrap:jmeter (o definí JMETER_HOME) e instalá Java 8 o superior en el PATH (o definí JAVA_HOME).npm run perf no corre un perfil con carga desde el agente
--confirmar, que el agente agrega solo después de tu confirmación.Una carpeta de Xray/QMetry/AIO aparece como C:/Program Files/Git/…
/ inicial: "HU-001 Registro".Un conector MCP no conecta
claude (no en el .env). Atlassian y Figma se autorizan desde /mcp.¿Los tests verifican la base de datos siempre?
.feature solo cuando las pedís, y sin DB_CONEXIONES en el .env la suite corre igual que siempre.Falta una librería de Python
pip install -r requirements.txtExtender el proyecto
Agregar un agente
- Creá el archivo
.claude/agents/mi-agente.mdcon frontmatternameydescription. La descripción es lo que usa Claude Code para decidir cuándo invocarlo y se carga en cada sesión: una o dos frases (máximo 400 caracteres) con qué hace, cómo se lo pide y en qué se diferencia del agente más parecido. - Cuerpo corto, referencia en un skillEn el agente van el rol, el flujo, las reglas y la salida. Las tablas de criterios, catálogos y formatos largos van a un skill, que se carga solo cuando hace falta.
- Escribí el cuerpoEn español: rol, entradas, proceso, salida y reglas.
- Definí el formatoSi genera un formato propio, sumá su plantilla en
plantillas/o su script enscripts/, y su carpeta enoutput/. - Normalizá las tablasSi genera tablas en un
.md, pasalas porscripts/formatear_tablas.py. - Informe en dos idiomasSi arma un informe HTML, escribilo con
escribir_bilingueylocalizar(scripts/_i18n.py), sumá sus textos al diccionarioscripts/i18n/en/y pedile al agente el bloque"en"del JSON. - Si necesita una respuesta de la personaCopiá la sección "Cuando te falta un dato o una confirmación" de cualquier agente: los subagentes no pueden preguntar a mitad del trabajo, así que devuelven "Necesito que confirmes".
Skills, conectores y herramientas
Skill
Una carpeta en .claude/skills/ con su SKILL.md; se carga solo cuando hace falta.
Conector MCP
Una entrada en .mcp.json, sin secretos; los tokens se leen del .env con un script de scripts/mcp/.
Herramienta
Una subcarpeta en herramientas/ con su README.
Tests del repo
python -m pytest tests y npm run test:repo. El CI los corre en Ubuntu y Windows (con el control estricto de traducciones), más un job con navegador real y los evals con referencia. Sumá un test cuando cambies un script.
Script de Python con atajo
En package.json: "mi-script": "node scripts/py.js scripts/. En el plugin queda como k0lmenia mi-script.
Publicar el plugin
En cada push a main, el workflow plugin.yml corre python scripts/construir_plugin.py y publica el resultado en la rama plugin. El armado traduce los comandos de agentes y skills (npm run x → k0lmenia x), pasa los estándares de CLAUDE.md al skill estandares y suma el hook de inicio, los conectores y el marketplace. Para probarlo en tu PC: claude --plugin-dir dist/plugin y claude plugin validate dist/plugin.
Regenerar esta documentación
node docs/generar.js # diagramas (PNG) y PDF en los dos idiomas, con el Playwright de k0lmenaLos PDF no se versionan: los publica el workflow documentacion.yml en el release docs cada vez que cambia docs/.
El sitio es docs/index.html (publicado con GitHub Pages en underc0delabs.github.io/K0lmenIA); el PDF sale del mismo HTML con estilos de impresión, y los diagramas de docs/diagramas/. La versión en inglés está en docs/en/index.html (con sus diagramas en docs/diagramas/en/): si cambiás esta página, actualizá también esa; las dos usan los mismos id de sección.
Licencia
Licencia MIT — © 2026 QARMY. k0lmena es un proyecto open source de Danilo Vezzoni. Hecho por la comunidad de Underc0de.
¿Lo querés en tu equipo?
Lo instalamos, lo conectamos con tus herramientas y capacitamos a tu equipo.
Consultar por WhatsApp